Notions Réseau
Une petite collection de notions réseau que j’enrichis au fil de mes découvertes, surtout quand je tombe sur des sujets que j’ai envie de mieux comprendre au travail.
- Les enregistrements DNS
- Qu'est-ce qu'une DMZ
- Comprendre RADIUS
- La fibre optique : Comprendre FTTH, FTTB et FTTx
- A quoi sert un reverse proxy ?
- C’est quoi le MTU ?
Les enregistrements DNS
Les enregistrements DNS (Domain Name System) sont très importants pour le fonctionnement d'Internet, permettant la traduction des noms de domaine faciles à retenir en adresses IP que les machines utilisent pour communiquer entre elles.
Voici un guide compact pour comprendre les types d'enregistrements DNS les plus courants et leur fonction.
1. Enregistrement A (Address Record)
- Fonction : Associe un nom de domaine à une adresse IPv4.
- Usage : Fondamental pour diriger le trafic vers l'hébergement d'un site web.
2. Enregistrement AAAA
- Fonction : Similaire à l'enregistrement A, mais associe un nom de domaine à une adresse IPv6.
- Usage : Important pour le routage du trafic dans les réseaux supportant IPv6.
3. Enregistrement CNAME (Canonical Name)
- Fonction : Permet à un domaine de faire référence à un autre nom de domaine.
- Usage : Utile pour associer des sous-domaines à un domaine principal ou lorsque plusieurs domaines pointent vers le même serveur.
4. Enregistrement MX (Mail Exchange)
- Fonction : Dirige les emails envoyés à votre domaine vers les serveurs de messagerie.
- Usage : Essentiel pour la configuration de la messagerie électronique pour votre domaine.
5. Enregistrement TXT
- Fonction : Permet au propriétaire du domaine d'insérer du texte dans le DNS.
- Usage : Souvent utilisé pour la vérification de la propriété du domaine, la configuration des politiques de sécurité email (SPF, DKIM, DMARC).
6. Enregistrement SRV (Service Record)
- Fonction : Fournit des informations sur les services disponibles sous un domaine spécifique, incluant le nom du service, le protocole, le port, et le nom d'hôte du serveur.
- Usage : Utilisé pour des services spécifiques tels que la VoIP, les services de messagerie instantanée.
7. Enregistrement NS (Name Server)
- Fonction : Indique quels serveurs DNS sont autoritatifs pour un domaine.
- Usage : Fondamental pour la délégation de sous-domaines et la gestion des réponses DNS.
Bonnes pratiques pour la gestion des enregistrements DNS
- Planification : Avant de modifier vos enregistrements DNS, assurez-vous de bien comprendre l'impact de ces changements.
- Sécurité : Utilisez des enregistrements TXT pour appliquer des politiques SPF, DKIM, et DMARC afin de réduire le risque de phishing et d'autres formes d'abus email.
- Redondance : Assurez-vous que votre domaine est servi par plusieurs serveurs DNS pour améliorer la disponibilité
- Documentation : Gardez une trace de tous les changements apportés à vos enregistrements DNS pour faciliter le dépannage et la maintenance futurs.
Les enregistrements DNS sont vitaux pour le bon fonctionnement d'Internet. Ils aident à diriger le trafic web vers les bons endroits, permettant aux gens de trouver ce qu'ils cherchent rapidement et en toute sécurité. Savoir comment ils fonctionnent peut vraiment améliorer la façon dont vous gérez vos sites et services en ligne.
Qu'est-ce qu'une DMZ
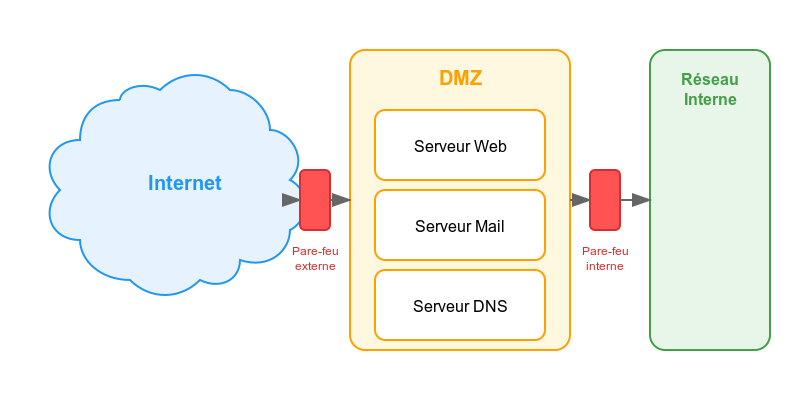
Une DMZ (pour Demilitarized Zone ou zone démilitarisée) est une partie d'un réseau informatique qui sert d'intermédiaire entre un réseau interne d'une organisation (souvent sécurisée) et un réseau externe (souvent internet).
Voici les points importants à retenir :
- Séparation des environnements :
La DMZ permet d'isoler les serveurs exposés (sites internet, serveurs de messagerie, de fichiers, etc.) du réseau interne. Ainsi, même si une personne malveillante compromet un serveur dans la DMZ, il ne peut pas accéder directement aux ressources critiques de l'entreprise. - Renforcement de la sécurité
En filtrant et en contrôlant le trafic entre le réseau public et le réseau privé, la DMZ ajoute une couche de défense supplémentaire, réduisant les risques d'attaques directes sur le réseau interne.
- Gestion des accès :
Des règles de pare-feu strictes sont mises en place pour limiter les communications entre la DMZ, généralement l'on ouvre les accès pour que notre service fonctionne, rien de plus. Cela limite les communications entre la DMZ, le réseau interne et internet et de contrôler précisément qui a accès à quoi. - Utilisation typique :
On y héberge souvent des serveurs qui doivent être accessibles depuis l'extérieur (sites web, serveurs d'applications publiques, etc.) tout en préservant la sécurité du réseau interne.
Exemple de schéma d'architecture réseau avec DMZ
Comprendre RADIUS
Le protocole RADIUS (Remote Authentication Dial-In User Service) est un outil qui aide à gérer qui peut accéder à un réseau et ce qu'il peut y faire. Imaginez que vous ayez un club privé, et que pour entrer, chaque personne doit montrer son badge pour prouver qu'il est membre. RADIUS fonctionne de manière similaire pour les réseaux (c'est un peu le videur musclé devant la porte).
Qu'est-ce que RADIUS ?
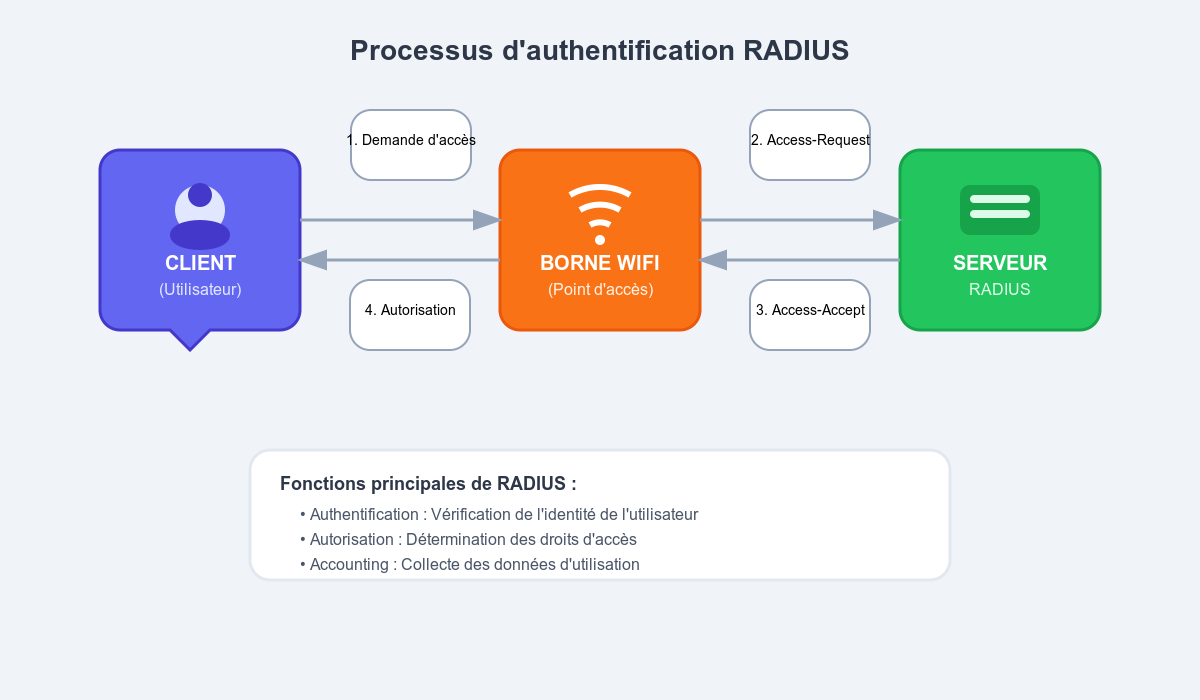
RADIUS est un système qui se trouve généralement sur un serveur central et qui gère trois fonctions principales :
- Authentification :
C'est le processus qui vérifie l'identité de l'utilisateur. Par exemple, quand vous vous connectez à un réseau Wi-Fi, vous entrez votre nom d'utilisateur et votre mot de passe. RADIUS vérifie ces informations pour s'assurer que vous êtes bien celui que vous prétendez être.
- Autorisation :
Une fois que RADIUS a confirmé votre identité, il décide de ce à quoi vous avez le droit d'accéder. Dans notre exemple du club privé, c'est pour vérifier que vous avez accès à certaines zones réservées ou à certains services une fois que vous êtes entré. - Suivi des connexions (Accounting) :
RADIUS garde une trace de ce que vous faites pendant que vous êtes connecté. Cela peut inclure la durée de votre session, les ressources que vous avez utilisées, etc. Cela permet d'aider à surveiller l'utilisation du réseau, à résoudre des problèmes ou même à facturer des services dans certains cas.
Comment ça marche ?
Voici une explication étape par étape, comme si vous assistiez à une petite démonstration :
- Connexion :
Vous (ou votre appareil) essayez de vous connecter au réseau. Vous entrez vos identifiants (nom d'utilisateur et mot de passe).
- Envoi de la demande :
Votre appareil envoie ces informations à un dispositif d'accès (comme un point d'accès Wi-Fi), qui à son tour les transmet au serveur RADIUS. - Vérification :
Le serveur RADIUS reçoit la demande et la compare avec ses données (qui peuvent provenir d'une base de données, d'un annuaire Active Directory ou d'un autre système de gestion des utilisateurs). Si vos informations correspondent, il vous authentifie. - Définition des droits d'accès :
Une fois authentifié, RADIUS vérifie également à quelles ressources vous avez le droit d'accéder (par exemple, accéder à certains services ou sections du réseau). - Suivi de la session :
Pendant que vous êtes connecté, le serveur enregistre les informations sur votre session. Cela peut aider l'administrateur du réseau à surveiller l'activité ou à détecter des comportements malveillants ou inhabituels
Pourquoi utiliser RADIUS ?
Pour résumer, RADIUS est très utile, car il permet de :
- Centraliser la gestion des accès :
Au lieu de devoir configurer chaque point d'accès ou service séparément, toutes les demandes sont gérées par un seul serveur. Cela simplifie la vie de l'administrateur réseau.
- Renforcer la sécurité :
En vérifiant l'identité des utilisateurs et en limitant ce qu'ils peuvent faire, RADIUS aide à protéger le réseau contre les accès non autorisés. - Suivre l'utilisation du réseau :
Grâce aux données enregistrées, il est plus facile de comprendre comment le réseau est utilisé et d'identifier rapidement les problèmes ou les tentatives d'intrusion.
La fibre optique : Comprendre FTTH, FTTB et FTTx
Le déploiement de la fibre optique a révolutionné la connectivité Internet en offrant des débits bien supérieurs aux technologies comme l'ADSL. Il existe plusieurs types de fibre optique selon le mode de raccordement ?
Qu'est-ce que la fibre optique ?
La fibre optique est une technologie de transmission de données basée sur des fils en verre ou en plastique ultra-fins, capable de transporter des signaux lumineux sur de longues distances. Contrairement aux câbles en cuivre de l'ADSL, la fibre permet des vitesses bien plus élevées et une meilleure stabilité.
Pourquoi la fibre est-elle plus performante que l'ADSL ?
- L'ADSL utilise des câbles en cuivre qui subissent une atténuation du signal sur de longues distances, car le cuivre transporte des signaux électriques qui se dégradent progressivement à mesure qu'ils parcourent le câble. Cette atténuation est due à la résistance du matériau et aux interférences électromagnétiques, ce qui réduit la vitesse et la qualité du signal,
notamment au-delà de quelques kilomètres.
À l'inverse, la fibre optique utilise des impulsions lumineuses transmises à travers un noyau en verre ou en plastique. La lumière étant beaucoup moins sujette aux pertes d'énergie que le courant électrique, elle peut parcourir plusieurs dizaines, voire centaines de kilomètres sans dégradation significative. - La fibre optique offre des débits symétriques, c'est-à-dire que les vitesses d'envoi et de réception des données sont similaires, contrairement à l'ADSL où l'envoi est plus lent que la réception.
- La latence est bien plus faible avec la fibre optique, car les signaux lumineux qu'elle transporte se déplacent beaucoup plus rapidement que les signaux électriques utilisés dans les câbles en cuivre, ce qui améliore les performances pour les jeux en ligne et la visioconférence.
Elle est utilisée pour divers types de raccordement, dont les plus courants sont :
- FTTH (Fiber To The Home) : Fibre jusqu'au domicile
- FTTB (Fiber To The Building) : Fibre jusqu'à l'immeuble
- FTTO (Fiber To The Office) : Fibre jusqu'aux bureaux
- FTTA (Fiber To The Antenna) : Fibre jusqu'aux antennes relais (4G/5G)
FTTH : La fibre jusqu'à la maison
Le FTTH est la technologie de fibre la plus répandue pour les particuliers. C'est très probablement celle que vous avez actuellement à la maison si vous êtes équipés de la fibre. Elle permet un raccordement direct de la fibre optique jusqu'à l'intérieur du logement. Cette connexion offre des débits élevés pouvant atteindre 1Gbit/s, voire 10Gbit/s dans certaines offres avancées, garantissant ainsi une connexion stable et fluide.
Le principal avantage du FTTH est qu'il ne dépend pas du réseau cuivre existant. Ainsi, même si vous habitez loin du nœud de raccordement, votre connexion ne subira pas de perte de performances.
FTTB : La fibre jusqu'à l'immeuble
Le FTTB est principalement utilisé pour raccorder les immeubles collectifs. La fibre arrive dans la cave ou un local technique, puis des câbles en cuivre ou coaxiaux distribuent la connexion aux logements. Cette solution est souvent mise en place dans les grandes villes où il est plus simple d'amener la fibre à un bâtiment plutôt qu'à chaque logement individuellement.
Les débits offerts en FTTB sont généralement compris entre 100 Mbit/s et 1Gbit/s, selon la qualité des câbles utilisés dans l'immeuble.
Le FTTB est une alternative intéressante lorsque le déploiement du FTTH est complexe. Toutefois, la présence de câbles en cuivre sur le dernier segment peut réduire légèrement la performance par rapport à une connexion entièrement en fibre.
FTTO : La fibre pour les entreprises
La FTTO est une solution dédiée aux entreprises, offrant un débit garanti et une qualité de service supérieure.
Contrairement à la FTTH, la bande passante n'est pas partagée avec d'autres abonnés grâce à l'utilisation d'une fibre dédiée.
La FTTO repose majoritairement sur une liaison point-à-point entre l'entreprise et le nœud de raccordement de l'opérateur.
Les débits proposés en FTTO varient généralement de 10Mbits/s à plusieurs Gbit/s, avec des garanties de services adaptées aux besoins professionnels.
Ce type de connexion est particulièrement adapté aux structures nécessitant une connexion fiable et sécurisée, comme les bureaux et les centres de données. Il permet également d'obtenir une garantie de temps de rétablissement (GTR), c'est-à-dire une intervention rapide en cas de panne.
FTTA : La fibre jusqu'aux antennes mobiles : 
La FTTA est utilisée pour relier les antennes 4G et 5G aux réseaux des opérateurs. Cela permet d'améliorer la couverture mobile et la qualité des connexions sans fil.
Sans fibre optique, le réseau mobile dépendrait uniquement de liaisons hertziennes, moins rapides et plus sensibles aux interférences. La FTTA garantit ainsi une meilleure expérience pour les utilisateurs de smartphone, en réduisant la latence et en augmentant les débits qui peuvent atteindre plusieurs Gbit/s pour assurer une bonne connectivité de la 5G.
Le futur de la fibre optique :
Le déploiement de la fibre continue à s'étendre, avec des innovations comme :
- La fibre 10G PON, qui permettra des débits encore plus élevés pour les particuliers et les entreprises.
- Le développement de la fibre quantique, qui pourrait révolutionner la cybersécurité en offrant des communications ultra-sécurisées.
- Une couverture plus large dans les zones rurales, grâce aux investissements des opérateurs ou des gouvernements.
Avec ces différentes technologies, la fibre optique s'adapte aux besoins variés des particuliers, des entreprises et des infrastructures mobiles.
A quoi sert un reverse proxy ?
Le problème quand on héberge plusieurs services
Quand on commence à héberger des services sur un serveur, on se retrouve assez vite avec plusieurs applications différentes. Par exemple un wiki, une interface de supervision, un cloud personnel, un gestionnaire de mots de passe etc.
Au début, on peut se dire que chaque application est facilement accessible avec son adresse IP et son port. Par exemple une application peut répondre sur le port 8080, une autre sur le port 3000, et une autre sur le port 5000, etc.
On se retrouve alors avec des adresses de ce genre :
http://192.168.1.50:8080
http://192.168.1.50:3000
http://192.168.1.50:5000
Techniquement, c'est vrai, ça fonctionne. Mais, ce n'est pas très propre, pas très pratique à retenir, et ce n'est pas forcément l'idéal niveau sécurité. C'est dans ce cas-là que l'on peut utiliser un Reverse Proxy.
Qu'est-ce qu'un reverse proxy
Un Reverse Proxy est un serveur qui se place devant les applications web. Il reçoit les demandes des utilisateurs, puis les transmet au bon service en interne. L'utilisateur ne contacte donc pas directement l'application finale, il contacte le reverse proxy. C'est lui qui va se charger de faire le lien avec la bonne application !
On peut l'imaginer comme par exemple, l'accueil d'un bureau administratif. Quand une personne arrive, elle ne connaît pas forcément le bureau ou elle doit se rendre. Elle donne simplement le nom de la personne ou du service qu'elle cherche, et l'accueil l'oriente au bon endroit. Le reverse proxy fait un peu la même chose, mais avec des sites web et des applications
Exemple concret avec plusieurs services
Si l'on reprend les adresses de tout à l'heure, imaginons que l'on ait trois services sur le même serveur
Un wiki sur le port 8080
Une supervision sur le port 3000
Une application web sur le port 5000
Sans reverse proxy, il faudait accéder directement à chaque port. Avec un reverse proxy, on peut utiliser des adresses beaucoup plus propres
https://wiki.exemple.fr
https://supervision.exemple.fr
https://app.exemple.fr
Le reverse proxy reçoit la requête, regarde le nom de domaine demandé, puis l'envoie vers le bon service. Si l'utilisateur demande wiki.exemple.fr, le reverse proxy, paf ! Il connait où se trouve le wiki et transmet la demande. Si l’utilisateur demande supervision.exemple.fr, il transmet la demande vers l’outil de supervision. Tout ça peut se faire sur un seul et même serveur.
Le cas particulier de Docker
C'est particulièrement pratique quand on utilise Docker. Beaucoup d'application Docker écoutent sur un port interne. Par exemple, une application peut fonctionner dans un conteneur sur le port 3000. On pourrait directement exposer ce port mais ce n'est pas idéal. Avec un reverse proxy, on peut garder l'application accessible uniquement en local sur le serveur puis laisser le reverse proxy s'occuper de l'accès depuis l'extérieur.
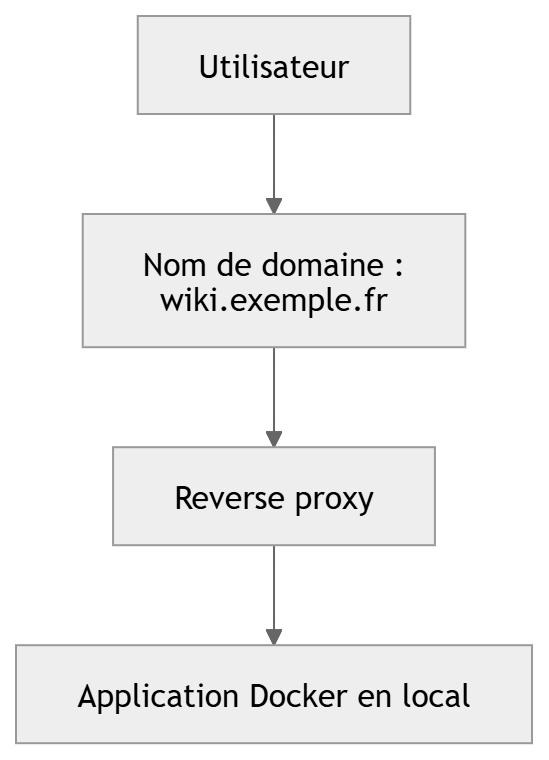
L'utilisateur n'a pas besoin de savoir que l'application tourne sur le port 3000, dans un conteneur Docker, sur une machine précise, c'est tout sauf pratique. L'utilisateur, pour lui, il visite juste une adresse web classique.
Gestion du HTTPS et des certificats
Un autre avantage du reverse proxy, c'est la gestion du HTTPS. Quand on héberge un site ou une application, on veut généralement éviter le simple HTTP, surtout si des informations personnelles ou des identifiants peuvent être entrées. Le reverse proxy peut gérer les certificats SSL/TLS et permettre aux utilisateurs d'accéder aux services en HTTPS.
Ce qui est cool, c'est que l'application derrière le reverse proxy peut parfois fonctionner en HTTP uniquement en local. Le reverse proxy, lui, s'occupe de présenter une connexion HTTPS sécurisée à l'utilisateur.
On peut donc avoir quelque chose comme ceci :
Utilisateur → HTTPS → Reverse proxy → HTTP local → Application
Vu de l'extérieur, la connexion est sécurisée. En interne sur le serveur, le reverse proxy discute avec l'application. Il permet donc de simplifier la gestion des certificats. Super bien quand on héberge plusieurs services
Réduction des ports exposés
Le reverse proxy permet également d'éviter d'ouvrir trop de ports vers internet. Au lieu d'exposer les ports 3000,5000,8080 et ainsi de suite, on expose juste les ports "classiques du web".
80 → HTTP
443 → HTTPS
C'est tout ! Ensuite, c'est le reverse proxy qui va s'occuper de rediriger les demandes vers les bons ports internes. Ça permet d'avoir une architecture beaucoup plus propre. Les applications ne sont pas toutes visibles depuis internet, et le reverse proxy devient le point d'entrée principal
Les outils de reverse proxy
Il existe plusieurs outils capables de faire reverse proxy. Le plus connu est probablement Nginx, très utilisé sur les serveurs Linux. Apache peut aussi faire ce rôle. Traefik est souvent utilisé avec Docker, car il peut détecter automatiquement les conteneurs et créer les routes correspondantes. Caddy est apprécié pour sa simplicité et sa gestion automatique du HTTPS. Il existe aussi Nginx Proxy Manager, qui permet de gérer des redirections depuis une interface web, ce qui peut être plus accessible quand on ne veut pas écrire toute la configuration à la main.
Reverse proxy vs proxy classique
Il faut aussi faire la différence avec un proxy classique. Un proxy classique est plutôt utilisé côté utilisateur. Par exemple, un ordinateur peut passer par un proxy pour accéder à Internet. Le reverse proxy, lui, est côté serveur. Il reçoit les demandes qui viennent d’Internet et les transmet aux applications hébergées derrière lui.
On peut résumer simplement comme ceci :
Proxy classique :
Ordinateur → Proxy → Internet

Reverse proxy :
Internet → Reverse proxy → Applications
Le proxy classique aide un utilisateur à sortir vers Internet. Le reverse proxy aide les utilisateurs à entrer proprement vers des services hébergés.
Résumons
Au final, un reverse proxy sert surtout à rendre l’hébergement de plusieurs applications beaucoup plus propre. Il permet d’utiliser de beaux noms de domaine, de gérer le HTTPS à un seul endroit, de masquer les ports internes, et d’envoyer chaque demande vers le bon service.
C’est un outil discret, mais extrêmement important dans une infrastructure web. Quand tout fonctionne bien, on ne le remarque presque pas. Pourtant, sans lui, beaucoup d’installations seraient vite moins pratiques, moins propres et plus compliquées à maintenir.
En résumé, le reverse proxy est un peu le GPS de votre serveur. L’utilisateur arrive avec une adresse, comme wiki.exemple.fr, et le reverse proxy sait exactement vers quelle application l’envoyer. Il simplifie l’accès, améliore l’organisation, et permet d’héberger plusieurs services proprement derrière une seule porte d’entrée.
C’est quoi le MTU ?
Introduction
Quand on parle de réseau, on imagine souvent que les données partent d’un ordinateur et arrivent directement à un serveur, un peu comme une lettre envoyée par la poste. En réalité, les données ne voyagent pas en un seul gros bloc. Elles sont découpées en petits morceaux, appelés des paquets.
Définition du MTU
Le MTU, pour Maximum Transmission Unit, correspond à la taille maximale qu’un paquet peut avoir pour passer sur un réseau.
Dit plus simplement : le MTU, c’est la taille maximale d’un paquet réseau avant qu’il ne soit trop gros pour passer correctement.
Une analogie simple
On peut l’imaginer comme une limite de taille pour un colis. Si le colis est assez petit, il passe normalement dans le camion, dans les machines de tri, puis arrive à destination. S’il est trop gros, il faut soit le découper en plusieurs colis, soit il risque d’être refusé quelque part sur le trajet.
En réseau, c’est un peu pareil. Si un paquet est trop gros pour un équipement ou une liaison, il peut être découpé, ralenti, ou parfois même bloqué.
Valeur classique du MTU
Sur un réseau Ethernet classique, la valeur de MTU la plus courante est :
1500 octetsCela veut dire qu’un paquet IP peut avoir une taille maximale de 1500 octets sur ce réseau. Ce n’est pas énorme, mais c’est largement suffisant pour transporter les données petit bout par petit bout.
Le MTU dans la pratique
Quand on charge une page web, qu’on regarde une vidéo, qu’on télécharge un fichier ou qu’on se connecte en VPN, beaucoup de paquets circulent en arrière-plan. On ne les voit pas, mais ils sont là, et le MTU définit la taille maximale de ces petits morceaux.
Le souci, c’est que tous les réseaux ne permettent pas forcément de faire passer des paquets de la même taille. Un réseau local peut accepter 1500 octets, mais dès qu’on ajoute certains éléments comme un VPN, du PPPoE, du tunnel GRE, de l’IPsec, du WireGuard ou d’autres encapsulations, une partie de la place disponible est utilisée pour ajouter des informations supplémentaires autour du paquet.
C’est comme si on mettait un colis dans une boîte, puis cette boîte dans une autre boîte. Le contenu n’a pas changé, mais l’emballage prend plus de place.
Résultat : un paquet qui passait très bien sur un réseau classique peut devenir trop gros une fois encapsulé dans un tunnel VPN.
Exemples de valeurs de MTU
C’est pour ça qu’on voit parfois des MTU plus petits, par exemple :
1500 → Ethernet classique
1492 → connexion PPPoE
1420 → souvent utilisé avec WireGuard
1400 → valeur prudente pour certains VPN ou tunnels
Ce ne sont pas des règles absolues, mais ça donne une idée. Plus il y a de couches autour du paquet, plus il faut parfois réduire le MTU pour éviter les problèmes.
Symptômes d’un MTU mal configuré
Quand le MTU est mal adapté, les symptômes peuvent être très étranges. Ce n’est pas forcément une panne franche où “rien ne marche”. Parfois, certaines choses fonctionnent très bien, et d’autres non.
Par exemple, on peut avoir Internet qui fonctionne, mais certains sites ne chargent pas. Une page peut commencer à s’afficher, puis rester bloquée. Un VPN peut se connecter, mais certains services derrière ne répondent pas. Une connexion SSH peut marcher, mais un transfert de fichier peut échouer. Un site peut être accessible depuis un réseau, mais pas depuis un autre.
C’est le genre de problème qui donne envie d’accuser le DNS, le pare-feu, le navigateur, le serveur, la météo, et probablement aussi l’imprimante du bureau. Pourtant, parfois, le coupable est simplement un MTU trop grand quelque part sur le chemin.
Path MTU Discovery
Normalement, les équipements réseau savent gérer ce problème grâce à un mécanisme appelé Path MTU Discovery. Le principe est assez simple : la machine essaie de découvrir la taille maximale des paquets qui peuvent passer jusqu’à la destination. Si un paquet est trop gros, un équipement réseau devrait répondre avec un message ICMP pour dire quelque chose comme : “ce paquet est trop gros, il faut envoyer plus petit”.
Le problème, c’est que ces messages ICMP sont parfois bloqués par des pare-feu mal configurés. Et là, la machine continue d’envoyer des paquets trop gros, sans comprendre pourquoi ça ne passe pas. On parle parfois de “black hole MTU (Le trou noir MTU)”, parce que les paquets disparaissent silencieusement.
Tester le MTU avec ping
Pour tester un problème de MTU, on peut utiliser la commande ping avec une taille précise et demander à ne pas fragmenter le paquet.
Sous Linux
On peut faire par exemple :
ping -M do -s 1472 exemple.frPourquoi 1472 et pas 1500 ? Parce qu’il faut ajouter les en-têtes IP et ICMP, qui prennent 28 octets. Donc :
1472 + 28 = 1500Si ça passe, cela veut dire qu’un paquet de 1500 octets passe correctement jusqu’à la destination. Si ça ne passe pas, on peut réduire progressivement la taille.
Par exemple :
ping -M do -s 1400 exemple.fr
ping -M do -s 1380 exemple.fr
ping -M do -s 1360 exemple.fr
L’idée est de trouver la plus grande taille qui passe encore correctement.
Sous Windows
On peut faire un test similaire avec :
ping exemple.fr -f -l 1472Ici, -f indique qu’on ne veut pas fragmenter le paquet, et -l permet de choisir la taille des données envoyées.
Si le test échoue, on peut réduire la valeur :
ping exemple.fr -f -l 1400
ping exemple.fr -f -l 1380
ping exemple.fr -f -l 1360
Une fois qu’on trouve la plus grande valeur qui fonctionne, il faut ajouter 28 pour obtenir le MTU approximatif.
Par exemple, si cette commande fonctionne :
ping exemple.fr -f -l 1392Alors le MTU correspondant est environ :
1392 + 28 = 1420C’est pour ça qu’on retrouve souvent 1420 dans des configurations VPN comme WireGuard.
Bonnes pratiques
Il faut quand même rester prudent : modifier le MTU au hasard n’est pas toujours une bonne idée. Le réduire trop bas peut fonctionner, mais ce n’est pas forcément optimal. Des paquets plus petits peuvent entraîner un peu plus de surcharge, car il faudra envoyer plus de paquets pour transporter la même quantité de données.
Le but n’est donc pas de mettre une valeur minuscule “pour être tranquille”, mais de trouver une valeur adaptée au chemin réseau utilisé.
Dans un réseau classique, on laisse généralement le MTU par défaut à 1500. Si on utilise un VPN, un tunnel ou une connexion particulière, il peut être nécessaire de descendre un peu. Dans beaucoup de cas, une valeur autour de 1400 ou 1420 peut résoudre des comportements bizarres liés aux tunnels.
Conclusion
Le MTU est donc un petit réglage discret, mais il peut avoir un gros impact. Quand il est bien configuré, on ne pense jamais à lui. Quand il est mal adapté, il peut provoquer des problèmes vraiment trompeurs : des sites qui chargent à moitié, des VPN instables, des connexions lentes ou des services accessibles uniquement dans certains cas.
En résumé, le MTU correspond à la taille maximale des paquets qui peuvent circuler sur un réseau. Si les paquets sont trop gros pour passer quelque part, ils doivent être fragmentés ou réduits. Et si le réseau ne gère pas correctement cette situation, certaines connexions peuvent se comporter bizarrement.
C’est un peu comme essayer de faire passer un meuble dans un couloir trop étroit. Si on peut le démonter proprement, tout va bien. Si personne ne dit qu’il bloque, on reste devant la porte à se demander pourquoi ça n’avance pas.