# Apprendre à parler à un glucomètre

Rétro-ingénierie d'un glucomètre Accu-Chek Guide pour aider un proche passé à l'insuline : récupérer toutes ses mesures en USB, sans cloud ni application du fabricant, pour les suivre facilement dans Glucofi.

# Pourquoi ce projet ?

Il y a quelque temps, le diabète d'un de mes proches a pas mal grimpé. Les comprimés ne suffisaient plus, et son médecin l'a fait passer sous **insuline**. Du jour au lendemain, le quotidien change : une piqûre le matin, une le soir, et surtout une glycémie à mesurer tous les matins à jeun avec un petit lecteur, un **Accu-Chek Guide** de chez Roche.

Et ce n'est pas tout. Le médecin lui a donné un protocole écrit : "si la glycémie du matin est au-dessus de tel seuil plusieurs jours de suite, on augmente la dose du soir de tant d'unités, si elle passe sous tel autre seuil, on la baisse". Bref, il faut noter chaque mesure, regarder les derniers jours, faire un petit calcul, et ramener tout ça au médecin au prochain rendez-vous.

Au début, tout se faisait sur un carnet papier. Sauf qu'un carnet, ce n'est pas pratique, ça s'oublie, on oublie de noter une valeur. Le lecteur, lui, garde pourtant **toutes** les mesures en mémoire, avec la date, l'heure, et même un marqueur "à jeun" ou "après repas". Les données sont là, dans le boîtier. Il fallait juste trouver un moyen de les sortir.

Voici comment j'ai fait.

### Les solutions "officielles"

Mon premier réflexe a été de regarder ce que propose Roche. De ce que j'ai trouvé, les solutions passent par une application (Gluci-chek) smartphone reliée à un compte en ligne, ou par des logiciels pensés pour Windows. Rien qui fonctionne simplement sur un PC Linux, sans compte, sans cloud, et sans envoyer des données de santé chez quelqu'un d'autre.

Il y a aussi **Tidepool**, un projet open source très sérieux qui sait lire énormément de lecteurs de glycémie. Mais son "uploader" est une application qui tournait dans Chrome, avec un compte Tidepool à la clé. Pas vraiment ce que je cherchais pour un proche pas fan de l'informatique qui veut juste brancher son lecteur et voir ses chiffres.

### La trouvaille : accuchek

En fouillant sur GitHub, je suis tombé sur [emogenet/accuchek](https://github.com/emogenet/accuchek) : un petit programme en C++ qui parle directement au lecteur en USB grâce à **libusb**, et qui recrache toutes les mesures. Son auteur avait fait le plus dur : il avait **rétro-ingénieré** le protocole de communication en lisant le code JavaScript du pilote Roche de Tidepool, et l'avait réécrit en C++ "brut".

[![entreprise.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/entreprise.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/entreprise.png)

C'était la bonne base, mais pour un usage au quotidien, il manquait des choses :

- les **marqueurs repas** (à jeun, avant repas, après repas, coucher...) n'étaient pas lus, alors que c'est justement ce qui permet de retrouver la glycémie du matin ;
- les mesures hors échelle "HI" et "LO" étaient jetées ;
- les dates étaient décalées d'une heure en été ;
- il fallait être **root** pour accéder au lecteur ;
- un paquet USB un peu bizarre pouvait faire lire le programme en dehors de sa mémoire ;
- pas de moyen simple de savoir *pourquoi* une lecture avait échoué.

J'ai donc forké le projet ([Ronnarrdd/accuchek](https://github.com/Ronnarrdd/accuchek)) et je l'ai repris en profondeur. C'est ce code que j'ai ensuite importé dans mon application de suivi, **Glucofi**.

### Les acteurs de la pièce

Pour bien comprendre la suite, voici qui fait quoi :

- **Le lecteur Accu-Chek Guide** : il fait les mesures et les stocke. Branché en micro-USB, il affiche "transfert de données" et attend qu'on lui parle.
- **Le PC sous Linux** (Mageia dans mon cas) : il voit le lecteur comme un périphérique USB.
- **accuchek** : le petit programme C++. Il trouve le lecteur, discute avec lui dans sa langue, récupère toutes les mesures et les écrit en **JSON**.
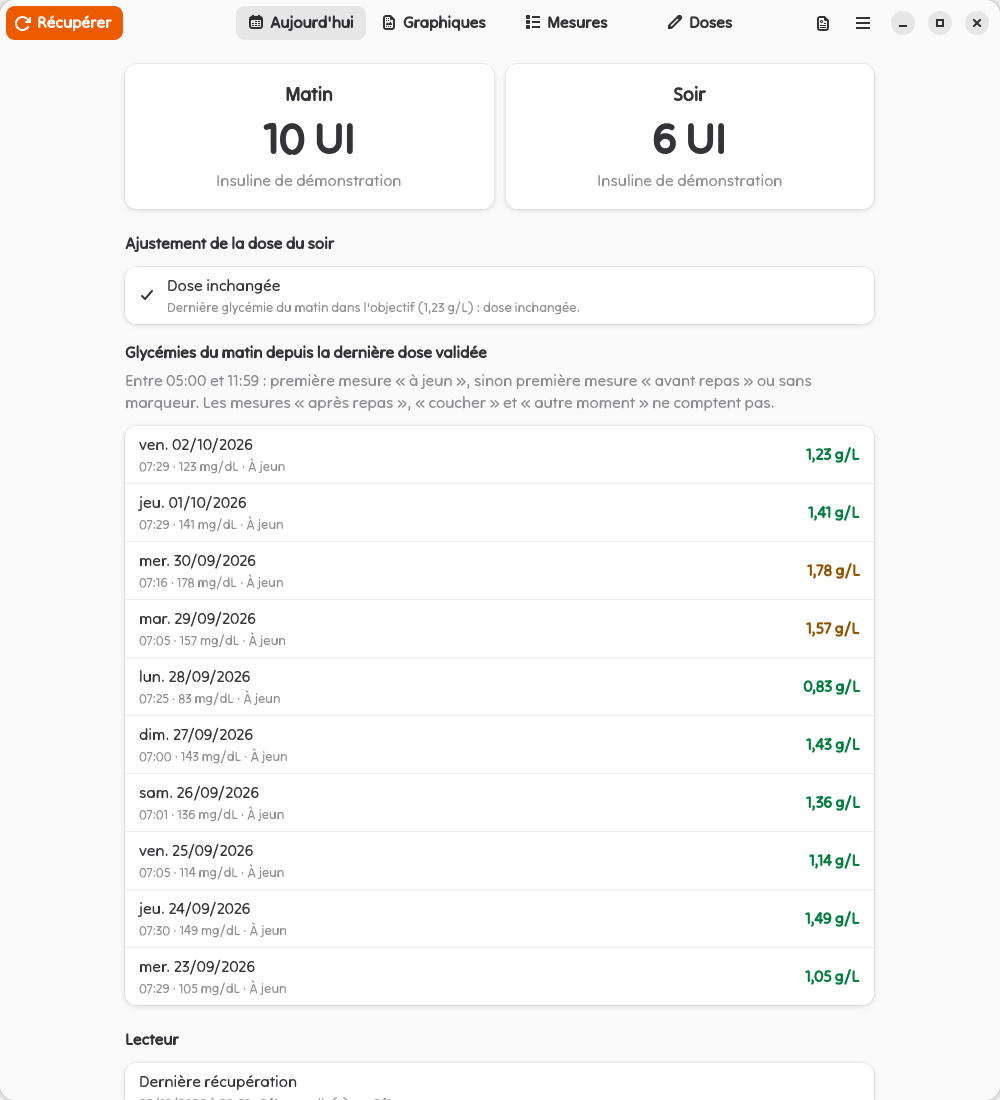
- **Glucofi** : l'application graphique (GTK4 / libadwaita) qui lance accuchek, range les mesures dans une base locale, fait les graphiques, propose l'ajustement de la dose du soir selon le protocole du médecin, et sort un PDF pour la consultation.

Dans ce livre, je vais surtout parler d'**accuchek** : comment le lecteur se présente à Linux, quelle "langue" il parle, comment se déroule la conversation octet par octet, et tout ce que j'ai dû faire pour rendre le programme fiable. Je garde Glucofi pour le dernier chapitre.

### Ce que ça donne au final

On branche le lecteur, on lance une commande, et on obtient ça :

```bash
$ accuchek > mesures.json
$ jq '.readings[-1]' mesures.json
{"id": 637, "epoch": 1790880420, "timestamp": "2026/10/01 20:47", "mg/dL": 104, "mmol/L": 5.777778, "status": 0, "meal": "fasting"}
```

Pas de cloud, pas d'application du fabricant, pas de navigateur, pas de root. Juste un câble USB et un fichier JSON.

<p class="callout warning">Ni accuchek ni Glucofi ne sont des dispositifs médicaux. Ils ne remplacent ni le lecteur, ni l'avis du médecin. Toutes les valeurs importantes se vérifient sur l'écran du lecteur, et toute décision sur l'insuline reste celle du médecin.</p>

### Au programme

1. Pourquoi ce projet ? (vous êtes ici) 
    
    [![universite.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/universite.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/universite.png)
2. Le lecteur vu par Linux
3. La langue du lecteur : ISO/IEEE 11073
4. La conversation, pas à pas
5. Identité, horloge et marqueurs repas
6. Blinder le code : tests, traces et fuzzing
7. Installer et utiliser accuchek
8. Et ensuite : Glucofi

# Le lecteur vu par Linux

Avant de parler au lecteur, il faut d'abord savoir comment Linux le voit. Et la bonne nouvelle, c'est que Linux, c'est trop bien et nous donne déjà plein d'indices, il suffit de les lire.

### Ce que dit le noyau au branchement

Quand on branche l'Accu-Chek Guide, le noyau l'annonce tout de suite dans ses journaux (`dmesg` ou `journalctl -k`) :

```bash
usb 3-1: new full-speed USB device number 59 using xhci_hcd
usb 3-1: New USB device found, idVendor=173a, idProduct=21d5, bcdDevice= 1.00
usb 3-1: New USB device strings: Mfr=1, Product=2, SerialNumber=0
usb 3-1: Product: ACCU-CHEK Guide
usb 3-1: Manufacturer: Roche
```

Deux numéros sont importants ici :

- **idVendor = 173a** : c'est l'identifiant du fabricant, Roche ;
- **idProduct = 21d5** : c'est le modèle, ici l'Accu-Chek Guide.

Ce couple `173a:21d5`, c'est un peu la plaque d'immatriculation du lecteur. accuchek s'en sert pour savoir à qui il a affaire, et il ne touche à **aucun autre** périphérique USB.

### Regarder sous le capot avec lsusb

Pour avoir plus de détails, la commande `lsusb -v` décrit tout ce que le lecteur déclare. Voici les parties qui nous intéressent :

```bash
Bus 003 Device 118: ID 173a:21d5 Roche
bNumConfigurations 1
Configuration Descriptor:
bNumInterfaces 1
bConfigurationValue 1
Interface Descriptor:
bInterfaceNumber 0
bAlternateSetting 0
bNumEndpoints 2
bInterfaceClass 15
iInterface 4 Personal Healthcare Device Class
Endpoint Descriptor:
bEndpointAddress 0x81 EP 1 IN
Transfer Type Bulk
wMaxPacketSize 0x0040 1x 64 bytes
Endpoint Descriptor:
bEndpointAddress 0x01 EP 1 OUT
Transfer Type Bulk
wMaxPacketSize 0x0040 1x 64 bytes
```

Il y a une ligne qui m'a mis sur la piste : **bInterfaceClass 15, "Personal Healthcare Device Class"** (PHDC). Ce n'est pas un protocole maison bricolé par Roche (ce qui nous arrange pas mal), c'est une classe USB standard faite pour les appareils de santé personnels : tensiomètres, balances, glucomètres... On y reviendra au chapitre suivant.

Le reste se lit assez facilement :

- **une seule configuration, une seule interface** : le lecteur ne sait faire qu'une chose ;
- **deux "endpoints"** (des tuyaux) de type **Bulk** : `0x81` pour recevoir (du lecteur vers le PC, "IN") et `0x01` pour envoyer (du PC vers le lecteur, "OUT") ;
- **64 octets** maximum par paquet.

<p class="callout info">Petite astuce pour s'y retrouver : en USB, le sens est toujours vu depuis le PC. "IN" veut dire "qui rentre dans le PC", donc ce que le lecteur nous envoie. Le bit de poids fort de l'adresse (le `8` de `0x81`) indique justement ce sens.</p>

### Comment accuchek reconnaît le lecteur

Dans `main.cpp`, la fonction `addDeviceIfAccuChek` passe en revue tous les périphériques USB et applique une série de filtres. Un périphérique n'est retenu que s'il coche toutes les cases :

1. [![cle-usb.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/cle-usb.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/cle-usb.png)
    
    son couple vendeur:produit est dans la liste des lecteurs connus (sinon on ne l'ouvre même pas) ;
2. il a exactement 1 configuration, 1 interface et 1 "alt setting" ;
3. il a exactement 2 endpoints de 64 octets, qui ne sont pas de type "interrupt" ;
4. il y en a un dans chaque sens (un IN et un OUT) ;
5. on arrive à l'ouvrir et à lire son nom de fabricant et de produit.

La liste des lecteurs connus est intégrée au programme :

<table id="bkmrk-identifiant-usb-lect"><thead><tr><th>Identifiant USB</th><th>Lecteur</th></tr></thead><tbody><tr><td><code>173a&#58;21d5</code></td><td>Accu-Chek Guide (modèle 925), testé</td></tr><tr><td><code>173a&#58;21d7</code></td><td>modèle Roche similaire, non testé</td></tr><tr><td><code>173a&#58;21d8</code></td><td>Relion Platinum (modèle 982)</td></tr></tbody></table>

On peut en ajouter ou en désactiver avec un petit fichier de configuration passé via `--config`, une ligne par modèle :

```bash
vendor_0x173a_device_0x21d5 1 # Roche Accu-Chek Guide (reports model 925)
vendor_0x173a_device_0x21d8 0 # désactivé
```

### Prendre la main sur le lecteur

Une fois le lecteur trouvé, `operateDevice` enchaîne les appels libusb classiques :

```cpp
libusb_open(dev, &devHandle); // ouvrir le périphérique
libusb_detach_kernel_driver(devHandle, interface); // décrocher un éventuel pilote du noyau
libusb_set_configuration(devHandle, configValue); // choisir la configuration
libusb_claim_interface(devHandle, interface); // réserver l'interface pour nous
libusb_set_interface_alt_setting(devHandle, interface, altSetting);
```

Ensuite, toute la discussion avec le lecteur passe par trois opérations seulement, regroupées dans une petite classe `LibusbTransport` :

- `controlStatus` : une requête USB standard `GET_STATUS`, le "toc toc" du début ;
- `bulkOut` : envoyer un message au lecteur sur l'endpoint OUT ;
- `bulkIn` : lire un message du lecteur sur l'endpoint IN.

Chaque transfert a un délai maximum de **5 secondes**. Si le lecteur ne répond pas (débranché, écran éteint...), on n'attend pas indéfiniment.

Ce découpage en trois opérations a l'air anodin, mais c'est ce qui m'a permis plus tard de rejouer des échanges enregistrés sans lecteur branché. J'en parle au chapitre 6.

### Le problème du root, et la règle udev[![analyste-de-donnees (1).png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/analyste-de-donnees-1.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/analyste-de-donnees-1.png)

Par défaut, sous Linux, un simple utilisateur n'a pas le droit d'ouvrir un périphérique USB "brut". La version d'origine devait donc tourner avec `sudo`. Ça marche, mais ce n'est pas terrible : un programme qui décode des paquets venant de l'extérieur n'a vraiment aucune raison d'avoir tous les droits sur la machine.

La solution propre, c'est une règle **udev**. udev est le service qui réagit au branchement des périphériques. Voici la règle installée dans `/etc/udev/rules.d/70-accuchek.rules` :

```bash
SUBSYSTEM=="usb", ENV{DEVTYPE}=="usb_device", ATTR{idVendor}=="173a", ATTR{idProduct}=="21d5|21d7|21d8", TAG+="uaccess"
```

En français : "quand un périphérique USB Roche de l'un de ces trois modèles arrive, colle-lui l'étiquette **uaccess**". Cette étiquette demande à systemd-logind de donner l'accès au périphérique à l'utilisateur de la **session locale active**, et à lui seul. La personne assise devant le PC peut lire son lecteur, un utilisateur connecté à distance en SSH non.

<p class="callout info">Le préfixe `70-` du fichier n'est pas là par hasard : la règle doit passer avant `73-seat-late.rules`, celle qui applique réellement les étiquettes `uaccess`. Avec un numéro plus grand, la règle serait lue trop tard et ne servirait à rien.</p>

Après l'installation de la règle, on recharge udev :

```bash
sudo udevadm control --reload
sudo udevadm trigger --subsystem-match=usb
```

Puis on débranche et on rebranche le lecteur. À partir de là, accuchek tourne avec les droits normaux de l'utilisateur.

### Savoir pourquoi ça ne marche pas

J'ai aussi fait en sorte qu'accuchek distingue bien les cas "pas de lecteur" et "lecteur trouvé mais accès refusé". Si un lecteur connu est sur le bus mais que `libusb_open` répond `LIBUSB_ERROR_ACCESS`, le programme le retient et le dit clairement :

```bash
$ accuchek
accuchek: permission denied on USB meter 173a:21d5 on bus 003 device 118
$ echo $?
3
```

Le code de sortie **3** veut dire "la règle udev manque ou n'est pas chargée", alors que le code **2** veut dire "aucun lecteur connu sur le bus". Ça a l'air d'un détail, mais c'est ce qui permet à Glucofi d'afficher le bon message ("rebranchez le lecteur" ou "relancez l'installation") au lieu d'une erreur qu'on ne comprendrait pas forcément.

# La langue du lecteur : ISO/IEEE 11073

Ouvrir le tuyau USB, c'est bien. Mais si on envoie n'importe quoi dedans, le lecteur ne répond rien, ou pire, il coupe la communication. Il faut parler sa langue. Et c'est là que commence vraiment le **reverse engineering**.

### D'où vient la connaissance du protocole ?[![medecin.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/medecin.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/medecin.png)
Roche ne publie pas de documentation sur le protocole de ses lecteurs. Par contre, il existe un endroit où quelqu'un l'a déjà implémenté : le pilote Roche du [Tidepool uploader](https://github.com/tidepool-org/uploader/tree/master/lib/drivers/roche), écrit en JavaScript.

Le chemin a donc été le suivant :

1. **emogenet**, l'auteur d'origine, a lu le code JavaScript de Tidepool, récupéré les constantes et l'ordre des messages, et réécrit l'ensemble en C++ au-dessus de libusb. Il le dit lui-même en commentaire dans le code : le pilote Tidepool "ne marche que dans Chrome", et son auteur "avait sans doute accès à un manuel décrivant le protocole".
2. En lisant ces constantes, on retrouve des noms comme `MDC_ATTR_TIME_ABS` ou `MDC_MOC_VMO_PMSTORE`. En cherchant ces noms, on tombe sur la norme **ISO/IEEE 11073-20601**, celle des "Personal Health Devices" de la [Continua Health Alliance](https://en.wikipedia.org/wiki/Continua_Health_Alliance). C'est le protocole qui va avec la classe USB PHDC qu'on a vue dans `lsusb`.
3. Pour tout ce que Tidepool ne lisait pas (l'identité du lecteur, son horloge, les marqueurs repas), je suis reparti de la norme et des projets libres qui l'implémentent, comme [Antidote](https://github.com/signove/antidote), puis j'ai comparé avec les vraies réponses de notre Accu-Chek Guide, capturés octets par octet.

<p class="callout info">Pour voir passer chaque paquet, il suffit de lancer `ACCUCHEK_DBG=1 accuchek`. Le programme écrit alors sur la sortie d'erreur un "hexdump" de chaque message envoyé et reçu, avec le numéro de l'étape. C'est l'outil principal de tout ce travail : on regarde les octets, on fait une hypothèse, on vérifie sur le message suivant.</p>

### Le principe : un "agent" et un "manager"

Dans cette norme, il y a deux rôles :

- **l'agent** : l'appareil de santé, ici le lecteur. C'est lui qui a les données ;
- **le manager** : celui qui les récupère, ici notre PC.

Le lecteur ne se contente pas d'envoyer une liste de chiffres. Il se décrit comme un ensemble d'**objets**, un peu comme une petite base de données :

- l'objet **MDS** (Medical Device System, handle 0) : le lecteur lui-même, avec son fabricant, son modèle, son numéro de série, son horloge ;
- l'objet **PM-Store** (Persistent Metric Store) : la mémoire où sont rangées les mesures ;
- des **segments** à l'intérieur du PM-Store : un segment pour les glycémies, un pour les mesures de contrôle, un pour les erreurs, un pour les marqueurs repas...

Chaque objet a un numéro (son "handle") et des **attributs**. Chaque attribut a un identifiant numérique standard, c'est la "nomenclature MDC". Par exemple :

<table id="bkmrk-nom-valeur-ce-que-c%27"><thead><tr><th>Nom</th><th>Valeur</th><th>Ce que c'est</th></tr></thead><tbody><tr><td><code>MDC&#95;MOC&#95;VMO&#95;PMSTORE</code></td><td>61</td><td>la classe "PM-Store", la mémoire des mesures</td></tr><tr><td><code>MDC&#95;ATTR&#95;NUM&#95;SEG</code></td><td>2385</td><td>nombre de segments dans le PM-Store</td></tr><tr><td><code>MDC&#95;ATTR&#95;ID&#95;MODEL</code></td><td>2344</td><td>fabricant et modèle</td></tr><tr><td><code>MDC&#95;ATTR&#95;TIME&#95;ABS</code></td><td>2439</td><td>l'horloge du lecteur</td></tr><tr><td><code>MDC&#95;ATTR&#95;SEG&#95;USAGE&#95;CNT</code></td><td>2427</td><td>nombre d'entrées dans un segment</td></tr><tr><td><code>MDC&#95;CTXT&#95;GLU&#95;MEAL&#95;FASTING</code></td><td>29268</td><td>marqueur "à jeun"</td></tr></tbody></table>

Dans `protocol.h`, toutes ces constantes sont rangées dans une grande liste `MDC_LIST`. Une petite astuce de préprocesseur C (les "X-macros") permet d'en tirer à la fois une énumération et une fonction `findKeyByValue` qui retrouve le nom à partir du numéro. Bien pratique quand on lit des logs.

### La forme d'un message

Tous les messages s'appellent des **APDU**. Ils commencent tous par 2 octets de type et 2 octets de longueur :

<table id="bkmrk-type-message-qui-l%27e"><thead><tr><th>Type</th><th>Message</th><th>Qui l'envoie</th></tr></thead><tbody><tr><td><code>E2 00</code></td><td>demande d'association ("on se connecte ?")</td><td>le lecteur</td></tr><tr><td><code>E3 00</code></td><td>réponse d'association ("d'accord")</td><td>le PC</td></tr><tr><td><code>E4 00</code></td><td>demande de fin d'association ("on raccroche")</td><td>le PC</td></tr><tr><td><code>E5 00</code></td><td>réponse de fin d'association</td><td>le lecteur</td></tr><tr><td><code>E6 00</code></td><td>abandon ("je coupe tout")</td><td>l'un ou l'autre</td></tr><tr><td><code>E7 00</code></td><td>message de données (tout le reste)</td><td>les deux</td></tr></tbody></table>

Les messages de données `E7 00` ont une structure un peu plus riche :

```bash
E7 00    type : message de données
00 0E    longueur de ce qui suit
00 0C    longueur du contenu
00 11    invoke-id : numéro de la question
01 03    type d'opération : ici "GET" (lire des attributs)
00 06    longueur de l'opération
00 00    handle de l'objet visé (0 = le lecteur lui-même)
...      le reste dépend de l'opération
```

Le type d'opération (le "data choice") dit ce que fait le message :

<table id="bkmrk-code-signification-0"><thead><tr><th>Code</th><th>Signification</th></tr></thead><tbody><tr><td><code>01 01</code></td><td>le lecteur signale un événement et attend un accusé de réception</td></tr><tr><td><code>02 01</code></td><td>l'accusé de réception de cet événement</td></tr><tr><td><code>01 03</code></td><td>demande de lecture d'attributs (GET)</td></tr><tr><td><code>02 03</code></td><td>réponse à cette lecture</td></tr><tr><td><code>01 07</code></td><td>demande d'action (lister les segments, lancer un transfert, régler l'heure...)</td></tr><tr><td><code>02 07</code></td><td>réponse à cette action</td></tr></tbody></table>

### L'invoke-id, ou le numéro de ticket

L'**invoke-id**, c'est le numéro de ticket de la conversation. Chaque question porte un numéro, et la réponse reprend le même numéro. Le lecteur s'attend à ce que le numéro de la question suivante soit le précédent plus un. Si on se trompe de numéro, il considère que la conversation est cassée.

Dans le code, après chaque message reçu, `updateInvokeId()` relit ce numéro (octets 6 et 7), et les messages que l'on construit utilisent `invokeId + 1`. C'est une des choses les plus faciles à rater quand on réécrit le protocole, et le lecteur ne prévient pas : il abandonne, tout simplement.

### Tout est en "big endian"

Les nombres sur plusieurs octets sont écrits **octet de poids fort en premier** (big endian), comme on lit un nombre de gauche à droite. `00 70` vaut 0x0070, soit 112. C'est l'inverse de ce que fait un processeur x86, donc on ne peut pas juste copier les octets dans un entier : `protocol.cpp` a ses petites fonctions `be16`, `be32` (écriture) et `be16r`, `be32r` (lecture) pour ça. La norme appelle ces règles d'encodage **MDER** (Medical Device Encoding Rules).[![calendrier.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/calendrier.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/calendrier.png)

### Les dates en BCD


Dernière curiosité, et pas des moindres : les dates. Le lecteur les stocke sur 8 octets en **BCD** (Binary Coded Decimal). Chaque octet contient deux chiffres décimaux, un par moitié d'octet. Il suffit donc de lire l'hexadécimal "comme si c'était du décimal" :

```bash
20 26 10 01 21 06 58 00
│  │  │  │  │  │  │  └── centièmes de seconde : 00
│  │  │  │  │  │  └───── secondes : 58
│  │  │  │  │  └──────── minutes : 06
│  │  │  │  └─────────── heures : 21
│  │  │  └────────────── jour : 01
│  │  └───────────────── mois : 10
│  └──────────────────── année : 26
└─────────────────────── siècle : 20

=> 2026/10/01 21:06:58
```

Le code d'origine qualifiait ça de "weird-ass encoding", et ça m'a bien fait rire ! Je dois avouer que la première fois qu'on voit `0x26` qui veut dire 26 et pas 38, ça surprend. La fonction `decodeBcd` fait la conversion, et renvoie `-1` si un des deux chiffres dépasse 9 : dans ce cas l'octet n'est pas du BCD valide, et la date est marquée invalide au lieu de produire n'importe quoi.

```cpp
int decodeBcd(uint8_t x) {
    auto hi = (x >> 4);
    auto lo = (x & 0xF);
    if(9<hi || 9<lo) {
        return -1;
    }
    return 10*hi + lo;
}
```

Avec ces quelques règles en tête (APDU, invoke-id, big endian, BCD, nomenclature MDC), on a tout ce qu'il faut pour suivre la conversation complète entre le PC et le lecteur. C'est le sujet du chapitre suivant.

# La conversation, pas à pas

[![chat.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/chat.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/chat.png)

Maintenant qu'on connaît la grammaire, on peut écouter une conversation complète. Toute la séquence est écrite dans une seule fonction, `downloadSamples`, dans `session.cpp`. Elle suit un ordre strict : si on saute une étape ou qu'on inverse deux messages, le lecteur abandonne.

Pour illustrer, j'utilise une **trace** : un fichier texte où chaque ligne est un transfert USB. `>` veut dire "le PC envoie", `<` veut dire "le lecteur répond", `c` c'est le transfert de contrôle du début. Celle-ci vient des tests (`tests/fixtures/meals.trace`) : elle est construite par un simulateur calqué sur un vrai Accu-Chek Guide, avec des mesures inventées.

<p class="callout warning">Une trace enregistrée sur un vrai lecteur contient **toutes** les mesures de la personne. Ce sont des données de santé : on ne la publie pas, on ne la met pas dans un dépôt Git. Le `.gitignore` d'accuchek ignore d'ailleurs les fichiers `*.trace` en dehors des exemples de test.</p>

#### Vue d'ensemble

<table id="bkmrk-%C3%89tape-sens-message-1"><thead><tr><th>Étape</th><th>Sens</th><th>Message</th></tr></thead><tbody><tr><td>1</td><td>PC → lecteur</td><td>"toc toc" : requête USB <code>GET&#95;STATUS</code></td></tr><tr><td>2</td><td>lecteur → PC</td><td>demande d'association</td></tr><tr><td>3</td><td>PC → lecteur</td><td>association acceptée</td></tr><tr><td>4</td><td>lecteur → PC</td><td>description de ses objets (configuration)</td></tr><tr><td>5</td><td>PC → lecteur</td><td>"configuration bien reçue"</td></tr><tr><td>6-7</td><td>aller-retour</td><td>identité et horloge du lecteur (MDS)</td></tr><tr><td>8-9</td><td>aller-retour</td><td>liste des segments de la mémoire</td></tr><tr><td>(10-11)</td><td>aller-retour</td><td>mise à l'heure, seulement si demandée et utile</td></tr><tr><td>12...</td><td>boucle</td><td>transfert des glycémies, avec accusé de réception à chaque paquet</td></tr><tr><td>...</td><td>boucle</td><td>transfert des marqueurs repas</td></tr><tr><td>fin</td><td>aller-retour</td><td>fin d'association, on raccroche</td></tr></tbody></table>

### 1. Le "toc toc"

```bash
c 0000
```

On commence par une requête USB standard `GET_STATUS` sur le périphérique. Le lecteur répond deux octets à zéro. On ne se sert pas de cette réponse, mais c'est ce que fait le pilote Tidepool avant de commencer, et quand on reproduit un protocole qu'on ne connaît pas par cœur, on évite de retirer des étapes "pour voir". Dans le doute, je fais tout pareil.

### 2 et 3. La poignée de main 

```bash
< E2000032800000000001002A0000...
> E300002C0003507900268000000280008000000000000000800000000008123456780000000000000000000000000000
```

Le lecteur ouvre la discussion avec une demande d'association (`E2 00`). On lui répond (`E3 00`) avec un message entièrement construit par `buildAssociationResponse`. Décortiqué, ça donne :

```bash
E3 00          réponse d'association
00 2C          longueur : 44 octets
00 03          résultat : "accepté, configuration inconnue"
50 79          protocole 20601 (0x5079), la norme ISO/IEEE 11073-20601
00 26          longueur des infos de protocole
80 00 00 02    version du protocole
80 00          règles d'encodage : MDER
80 00 00 00    version de la nomenclature
00 00 00 00    unités fonctionnelles : association normale
80 00 00 00    type de système : "manager"
00 08          longueur de l'identifiant système
12 34 56 78 00 00 00 00   notre identifiant (fictif)
...
```

Le point important est le résultat `00 03`, "accepted-unknown-config" : on accepte la connexion mais on dit au lecteur qu'on ne connaît pas encore sa configuration. Du coup, il va nous la décrire. C'est exactement ce qu'on veut : on ne suppose rien, on lui demande de se présenter.

### 4 et 5. Le lecteur se décrit

```bash
< E700003A00380010010100320000FFFFFFFF0D1C00284000000200220006000100010006092F00027144003D01000002000C092100020100095100020004
> E7000016001400100201000E0000000000000D1C000440000000
```

Le lecteur envoie un événement `0D 1C` (MDC\_NOTI\_CONFIG) : la liste de ses objets. On n'a besoin que d'un seul d'entre eux, le **PM-Store**, la mémoire des mesures. `parseConfigInfo` le cherche par sa classe :

```bash
00 3D          classe 61 : MDC_MOC_VMO_PMSTORE, c'est lui
01 00          son handle : 0x0100
00 02          il a 2 attributs
00 0C          sur 12 octets
09 21 00 02 01 00    attribut 2337 (ID_HANDLE) = 0x0100
09 51 00 02 00 04    attribut 2385 (NUM_SEG)   = 4 segments
```

On retient le handle `0x0100` : toutes les questions sur la mémoire seront adressées à cet objet. Puis on accuse réception de la configuration (`02 01` + `0D 1C`, résultat `00 00` = acceptée), en reprenant l'invoke-id du lecteur (`00 10`).

### 6 et 7. Qui es-tu ?

```bash
> E700000E000C001101030006000000000000
< E70000AE00AC0011020300A6...
```

On demande tous les attributs de l'objet MDS (handle 0), c'est-à-dire le lecteur lui-même. Remarquez l'invoke-id : `00 11`, soit le `00 10` précédent plus un. La réponse contient le fabricant, le modèle, le numéro de série, le firmware et l'horloge. Je la décortique au chapitre suivant, parce qu'elle mérite qu'on s'y attarde.

### 8 et 9. Qu'est-ce que tu as en mémoire ?

```bash
> E7000014001200120107000C01000C0D0006000100020000
< E700012E012C00120207012601000C0D0120...
```

On demande au PM-Store (`01 00`) l'action `0C 0D` (SEG\_GET\_INFO) pour tous ses segments. Le lecteur répond avec la description de chacun d'eux. Sur le vrai Accu-Chek Guide, on en trouve quatre, avec des noms assez parlants :

<table id="bkmrk-instance-nom-contenu"><thead><tr><th>Instance</th><th>Nom</th><th>Contenu</th></tr></thead><tbody><tr><td>0</td><td><code>PMSegGluc</code></td><td>les glycémies</td></tr><tr><td>1</td><td><code>PMSegCtrl</code></td><td>les mesures de contrôle (solution de test)</td></tr><tr><td>2</td><td><code>PMSegError</code></td><td>les erreurs</td></tr><tr><td>3</td><td><code>PMSegCMeal</code></td><td>les marqueurs repas</td></tr></tbody></table>

C'est une des grosses différences avec la version d'origine, qui lisait simplement le segment 0. Le code ne se fie pas aux noms ni aux numéros : `segmentKind` lit la "carte" de chaque segment (l'attribut `PM_SEG_MAP`), qui décrit le format exact de ses entrées :

- **glycémies** : objet numérique, partition 2, qui n'est pas une mesure de contrôle, avec une valeur sur 2 octets et un statut sur 2 octets ;
- **marqueurs repas** : objet "énumération", partition 128, code `MDC_CTXT_GLU_MEAL`, avec un code repas sur 2 octets.

Au passage, on récupère le compteur d'entrées de chaque segment (`SEG_USAGE_CNT`). Ça permettra de vérifier à la fin qu'on a bien tout reçu : "le lecteur annonce 638 mesures, on en a reçu 638".

### 12. Le transfert des glycémies

On demande le transfert du segment des glycémies avec l'action `0C 1C` (SEG\_TRIG\_XFER) :

```bash
> E7000010000E00130107000801000C1C00020000
< E7000012001000130207000A01000C1C000400000000
```

La réponse fait 22 octets. Les deux derniers sont le verdict : `00 00` veut dire "c'est parti", `00 03` veut dire "ce segment est vide" (un lecteur tout neuf, par exemple). Tout autre code est une erreur. Puis le lecteur commence à envoyer ses paquets de données :

```bash
< E700003800360020010100300100FFFFFFFF0D2100260000000000000000000280000018202609300731120000700000202609301302400000B60000
```

C'est le message le plus intéressant de toute la conversation. Le voici découpé :

```bash
E7 00 00 38 00 36    message de données, longueurs
00 20                invoke-id choisi par le lecteur
01 01                événement à confirmer
00 30                longueur
01 00                objet : le PM-Store
FF FF FF FF          temps relatif (non utilisé)
0D 21                événement MDC_NOTI_SEGMENT_DATA : "voici des mesures"
00 26                longueur
00 00                instance du segment (0 = glycémies)
00 00 00 00          index de la première entrée de ce paquet
00 02                nombre d'entrées dans ce paquet : 2
80 00                statut : 0x80 = premier paquet (0x40 = dernier)
00 18                taille des entrées : 24 octets = 2 x 12

20 26 09 30 07 31 12 00   date BCD : 2026/09/30 07:31:12
00 70                     valeur : 0x70 = 112 mg/dL
00 00                     statut : 0, mesure normale

20 26 09 30 13 02 40 00   date BCD : 2026/09/30 13:02:40
00 B6                     valeur : 0xB6 = 182 mg/dL
00 00                     statut : 0
```

Chaque glycémie tient donc sur **12 octets** : 8 pour la date, 2 pour la valeur en mg/dL, 2 pour le statut. Les mmol/L sont simplement calculés en divisant par 18.

Après chaque paquet, il faut renvoyer un accusé de réception, sinon le lecteur n'envoie pas la suite :

```bash
> E700001E001C0020020100160100FFFFFFFF0D21000C000000000000000000020080
```

On y recopie l'invoke-id du lecteur (`00 20`), l'instance, l'index et le nombre d'entrées du paquet, suivis du statut `00 80`, qui signifie "le manager confirme".

<p class="callout info">Petite anecdote de reverse engineering : dans le code d'origine (et dans Tidepool), ces champs s'appelaient simplement `u0`, `u1` et `u2`, des valeurs "qu'on renvoie telles quelles" sans trop savoir ce qu'elles sont. En les comparant à la norme, on comprend que ce sont l'instance du segment, l'index de la première entrée, le nombre d'entrées et le statut du paquet. Le code garde ces noms, mais on sait maintenant ce qu'il recopie.</p>

La boucle continue jusqu'au paquet dont le statut a le bit `0x40` ("dernier paquet"). Détail qui m'a fait chercher un moment : pendant cette boucle, les invoke-id sont ceux du **lecteur** (`00 20`, `00 21`...). Une fois le segment terminé, il faut revenir à *notre* numérotation, celle de la réponse au déclenchement du transfert. C'est le rôle de la variable `answerInvokeId` dans `transferSegment`.

### Le transfert des marqueurs repas

Si le lecteur a un segment de marqueurs repas non vide, on recommence exactement la même danse avec son instance (ici la 3). Les entrées sont plus petites, **10 octets** :

```bash
20 26 09 30 07 31 12 00   date BCD : 2026/09/30 07:31:12
72 54                     code repas : 29268 = à jeun
```

Il n'y a pas de valeur de glycémie ici : juste une date et un code. Comment on relie ce marqueur à la bonne mesure ? Je l'explique au chapitre suivant.

### Fin. On raccroche proprement

```bash
> E40000020000
< E50000020000
```

On envoie une demande de fin d'association (`E4 00`, "fin normale") et le lecteur confirme (`E5 00`). Transfert terminé s'affiche sur l'écran du glucomètre

Un choix que j'ai fait ici : si cette toute dernière étape échoue (lecteur débranché un poil trop tôt, par exemple), on **garde** quand même les mesures. Tous les paquets ont déjà été confirmés, les données sont complètes, il n'y a aucune raison de les jeter pour un "au revoir" manqué.

### Et si le lecteur coupe en plein milieu ?

À n'importe quelle étape, le lecteur peut envoyer un abandon (`E6 00`) au lieu de la réponse attendue. La fonction `receive` le détecte à chaque message reçu et arrête tout avec un message précis, du genre `received association abort request instead of MDS attribute answer`. Pas de mesures à moitié lues : on recommencera.

# Identité, horloge et marqueurs repas

La version d'origine savait récupérer les glycémies, et c'était déjà beaucoup. Mais pour le suivi de mon proche, il me fallait trois choses en plus : savoir **quel lecteur** on lit, savoir si son **horloge est juste**, et récupérer les **marqueurs repas**. Sans ces marqueurs, impossible de savoir quelle mesure est "la glycémie du matin à jeun", celle sur laquelle repose tout le protocole du médecin.

Ce chapitre, c'est la partie que Tidepool ne m'a pas mâchée. Il a fallu repartir de la norme et des vrais octets.[![universite (1).png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/universite-1.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/universite-1.png)
### Décortiquer la carte d'identité du lecteur

Voici la réponse d'un vrai Accu-Chek Guide (modèle 925, firmware v1.9.6) à la demande d'attributs MDS. Le numéro de série, l'identifiant système et l'horloge ont été remplacés, mais la structure est d'origine :

```bash
E700 00D4 00D2 00A4 0203 00CC 0000 0008 00C6     en-tête : réponse GET, 8 attributs

0928 000E  0006 526F63686500  0004 39323500       ID_MODEL
0984 000A  0008 0060190000000042                  SYS_ID
0A44 0002  4000                                   DEV_CONFIG_ID
092D 0056  0003 0052                              ID_PROD_SPECN, 3 entrées :
0001 0000 001A 73657269616C2D6E756D6265723A20393235303030303030343200
0003 1000 0012 68772D7265766973696F6E3A2047000000000000
0005 0000 0014 66772D7265766973696F6E3A2076312E392E3600
0987 0008  2026100121065800                       TIME_ABS
0A45 0010  C000 1F00 FFFFFFFF 0064 000000000000   MDS_TIME_INFO
0A4B 0016  ...                                    REG_CERT_DATA_LIST
0A5A 0008  0001 0004 1011 0002                    SYS_TYPE_SPEC_LIST
```

Chaque attribut suit le même schéma : 2 octets d'identifiant, 2 octets de longueur, puis la valeur. Ligne par ligne :

- `02 03` : c'est bien la réponse à notre GET. `00 08` : elle contient 8 attributs.
- `09 28` (2344, `ID_MODEL`) : deux chaînes de caractères. `526F636865` en ASCII donne **"Roche"**, `393235` donne **"925"**.
- `09 84` (2436, `SYS_ID`) : l'identifiant système du lecteur sur 8 octets (un EUI-64), écrit en hexadécimal dans la sortie.
- `09 2D` (2349, `ID_PROD_SPECN`) : une liste de "spécifications de production". Chaque entrée a un type : **1** pour le numéro de série, **3** pour la version matérielle, **5** pour le firmware. En ASCII : `serial-number: 92500000042`, `hw-revision: G`, `fw-revision: v1.9.6`. Roche met une étiquette devant la valeur, la fonction `afterLabel` garde ce qui suit le `": "`.
- `09 87` (2439, `TIME_ABS`) : l'horloge du lecteur, en BCD : **2026/10/01 21:06:58**.
- `0A 45` (2629, `MDS_TIME_INFO`) : les capacités de l'horloge. Les deux premiers octets, `C0 00`, sont des bits. `0x8000` veut dire "j'ai une horloge temps réel" et `0x4000` veut dire **"on peut me mettre à l'heure"**. C'est ce bit que teste le code.
- `0A 5A` (2650, `SYS_TYPE_SPEC_LIST`) : le profil d'appareil. `10 11` (4113) correspond au profil "glucomètre" de la norme (ISO/IEEE 11073-10417), en version 2. La confirmation que l'on parle bien à un appareil standard, et pas à un protocole maison.

Le décodage est fait par `parseMdsAnswer`, qui parcourt les attributs un par un et ignore ceux qu'il ne connaît pas. Si un lecteur ne donne pas certains attributs, les champs restent vides, et si la réponse n'est pas compréhensible du tout, la sortie indique simplement `"meter": null`. On ne bloque pas le téléchargement des mesures pour une carte d'identité mal lue.

### L'horloge : un détail qui n'en est pas un

Le lecteur date chaque mesure avec **sa propre horloge**. Si elle a 25 minutes d'avance, toutes les mesures ont 25 minutes d'avance. Et si elle n'a pas été changée au passage à l'heure d'hiver, une glycémie faite à 6h45 apparaît à 7h45... ou une mesure de 11h30 bascule après midi et sort de la plage "matin". Pour un protocole qui repose sur "la glycémie du matin", c'est gênant.

accuchek lit donc l'horloge du lecteur au début de la session et la compare à celle du PC. La sortie JSON le montre :

```json
"clock": {"meter": "2026/10/01 21:06:58", "pc": "2026/10/01 20:42:52", "offset_s": 1446, "settable": true, "pc_synchronized": true, "action": "set"}
```

Ici, le lecteur avait 1446 secondes d'avance, soit un peu plus de 24 minutes.

[![temps.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/temps.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/temps.png)
### Remettre le lecteur à l'heure, mais prudemment

Avec l'option `--set-time`, accuchek peut corriger l'horloge du lecteur. Le message est construit par `buildSetTime` : une action `0C 17` sur l'objet MDS (handle 0), avec la nouvelle date en BCD.

Écrire dans un appareil médical, ce n'est pas anodin. J'ai donc mis plusieurs garde-fous, testés dans cet ordre par `decideClock` :

1. on n'a rien demandé : on ne touche à rien (`not_requested`) ;
2. le lecteur n'a pas donné son heure : on ne sait pas, on ne touche à rien (`unknown`) ;
3. le lecteur ne déclare pas le bit "on peut me mettre à l'heure" : on ne touche à rien (`not_settable`) ;
4. l'heure du PC est inconnue : on ne touche à rien (`pc_unknown`) ;
5. l'heure du PC **n'est pas synchronisée par NTP** : on ne touche à rien (`pc_not_synchronized`). Pas question de recopier sur le lecteur l'heure d'un PC lui-même déréglé ;
6. l'écart est de 60 secondes ou moins : inutile, on laisse (`within_tolerance`) ;
7. sinon, on règle l'horloge (`set`).

Pour savoir si le PC est synchronisé, pas besoin d'être root : la fonction `systemClock` appelle `adjtimex` en lecture seule et vérifie que le noyau ne répond pas `TIME_ERROR`, c'est-à-dire que l'horloge est bien tenue à jour par NTP.

```cpp
PcClock systemClock() {
    struct timex tx;
    memset(&tx, 0, sizeof(tx));     // modes = 0 : lecture seule, aucun privilège
    auto state = adjtimex(&tx);
    return {time(0), true, 0<=state && TIME_ERROR!=state};
}
```

Si le lecteur refuse quand même la mise à l'heure, le téléchargement continue normalement et la sortie indique `"action": "rejected"`. Une horloge pas corrigée, ce n'est pas une raison de perdre les mesures.

<p class="callout info">L'option `--now`, qui permet de simuler une heure de PC, n'est acceptée qu'avec `--replay` (le rejeu d'une trace enregistrée). Une fausse heure ne doit jamais pouvoir atteindre un vrai lecteur.</p>

### Les marqueurs repas

Sur l'Accu-Chek Guide, après une mesure, on peut indiquer le moment : à jeun, avant repas, après repas... Ces marqueurs ne sont pas rangés avec les glycémies, mais dans **leur propre segment** (`PMSegCMeal`). Chaque entrée fait 10 octets : la date en BCD et un code de la nomenclature ISO/IEEE 11073-10417 (le profil "glucomètre" de la norme).

<table id="bkmrk-code-hexa-dans-la-so"><thead><tr><th>Code</th><th>Hexa</th><th>Dans la sortie</th><th>Signification</th></tr></thead><tbody><tr><td>29260</td><td><code>72 4C</code></td><td><code>before&#95;meal</code></td><td>avant repas</td></tr><tr><td>29264</td><td><code>72 50</code></td><td><code>after&#95;meal</code></td><td>après repas</td></tr><tr><td>29268</td><td><code>72 54</code></td><td><code>fasting</code></td><td>à jeun</td></tr><tr><td>29272</td><td><code>72 58</code></td><td><code>casual</code></td><td>moment quelconque</td></tr><tr><td>29300</td><td><code>72 74</code></td><td><code>bedtime</code></td><td>coucher</td></tr><tr><td>autre</td><td> </td><td><code>other</code></td><td>code inconnu</td></tr></tbody></table>

#### Recoller chaque marqueur à sa mesure

Le problème, c'est qu'un marqueur ne dit pas "je vais avec la mesure n°42". Il a juste une date. La seule façon de le relier à sa glycémie, c'est l'heure, et pas à la minute près : **à la seconde près**, octets bruts compris.

Le code garde donc, pour chaque glycémie et chaque marqueur, les 8 octets de date tels quels dans un entier de 64 bits (`timeKey`). Ensuite, `attachMeals` range les glycémies par date dans une table de hachage et y cherche chaque marqueur :

```cpp
std::unordered_map<uint64_t, std::vector<size_t>> byTime;
for(size_t i=0; i<samples.size(); ++i) {
    byTime[samples[i].timeKey].push_back(i);
}
for(const auto &m : meals) {
    auto it = byTime.find(m.timeKey);
    if(byTime.end()==it) {
        ++unmatched;     // marqueur sans mesure à la même seconde
        continue;
    }
    for(auto i : it->second) {
        samples[i].meal = m.meal;
    }
}
```

Les marqueurs qui ne trouvent pas leur mesure ne sont pas inventés ni rattachés "à peu près" : ils sont comptés, et le total apparaît dans la sortie (`"unmatched": 1`). Dans la trace de test du chapitre précédent, il y a justement un marqueur "avant repas" daté du 29/09 à 08:00:00 sans aucune glycémie à cette seconde-là. Il ressort comme orphelin.

Une dernière précaution dans `parseMealSegment` : un paquet de glycémies lu par erreur comme un paquet de marqueurs pourrait "tenir" dans la mémoire. Le code vérifie donc que le nombre d'octets annoncé correspond exactement à "nombre d'entrées x 10". Si ça ne colle pas, on s'arrête avec un message clair.

### HI et LO : les mesures hors échelle

Quand la glycémie est trop haute ou trop basse pour être mesurée, le lecteur affiche "HI" ou "LO". En mémoire, il ne stocke pas un nombre mais une valeur spéciale :

- `0x07FE` pour **HI** (au-dessus de la plage du lecteur) ;
- `0x0802` pour **LO** (en dessous).

La version d'origine les jetait. Or un "LO", c'est une hypoglycémie sévère : c'est sans doute la mesure qu'on a le moins envie de perdre ! Maintenant, elles sont gardées avec la convention de Tidepool : 601 mg/dL avec `"range": "high"`, ou 9 mg/dL avec `"range": "low"`. Le programme qui lit le JSON sait ainsi que ce n'est pas une vraie valeur mesurée, mais il sait qu'elle existe.

Dans le même esprit, **toutes** les mesures sont écrites, avec leur statut brut (0 pour une mesure normale). Une mesure dont la date n'est pas du BCD valide sort avec `"error": "invalid date"` au lieu de disparaître. C'est au programme qui lit la sortie de décider ce qu'il garde, pas à accuchek de trier en silence.

### Le bug de l'heure d'été

Dernier point, et c'est un classique. Le lecteur donne une heure "locale", sans fuseau horaire. Pour la convertir en `epoch` (nombre de secondes depuis 1970), on utilise `mktime`, en lui passant une structure `tm`. Dans cette structure, il y a un champ `tm_isdst` qui dit si on est en heure d'été.

Le code d'origine le mettait à 0, ce qui veut dire "heure d'hiver", toute l'année. Résultat : toutes les mesures prises en été avaient un `epoch` décalé d'une heure. La correction tient en une ligne :

```cpp
t.tm_isdst = -1;    // laisser les règles du fuseau horaire décider
```

Avec `-1`, c'est la base de fuseaux horaires du système qui décide, date par date, si on était en heure d'été ou non. Des tests vérifient ça noir sur blanc : une mesure affichée 07:36 le 2 juillet 2026 doit donner 05:36 UTC (heure de Paris en été), et des mesures juste avant et juste après les changements d'heure de mars et d'octobre doivent tomber au bon endroit. Le cas tordu de 02:30 le 25 octobre, une heure qui existe deux fois cette nuit-là, est aussi couvert : les deux réponses sont acceptées.

# Blinder le code : tests, traces et fuzzing

Comprendre le protocole, c'est la moitié du travail. L'autre moitié, c'est de s'assurer que le programme ne fait **jamais** n'importe quoi. Ces chiffres finissent dans le suivi d'un traitement à l'insuline : une mesure perdue, inventée ou décalée, ce n'est pas n'importe quoi

 Ce chapitre raconte tout ce que j'ai mis en place pour être certain de ne pas faire de bêtises

### Règle n°1 : ne jamais lire au-delà du paquet

Un paquet USB, c'est une suite d'octets qui vient de l'extérieur. Il annonce lui-même sa longueur, le nombre d'attributs, le nombre de mesures... Si on fait confiance à ces nombres sans vérifier, un paquet abîmé (ou un lecteur un peu exotique) peut faire lire le programme en dehors de sa mémoire. Au mieux il plante, au pire il renvoie des valeurs prises n'importe où.

Tous les décodeurs passent donc par une petite structure, `Reader`, définie dans `protocol.h`. Elle connaît la taille réelle de ce qu'on a reçu et refuse d'aller plus loin :

```cpp
uint16_t Reader::u16() {
    if(!has(2)) {
        ok = false;   // on retient que la lecture a débordé
        return 0;
    }
    return be16r(data, offset);
}
```

Dès qu'une lecture déborde, `ok` passe à `false` et toutes les lectures suivantes renvoient 0. Le décodeur vérifie `ok` au bon moment et s'arrête avec un message précis, par exemple :

```bash
accuchek: data segment announces 200 entries but holds 2
```

La méthode `sub(n)` crée un "sous-lecteur" limité aux `n` octets d'un attribut. Même si l'attribut ment sur sa propre longueur, on ne peut pas déborder sur le suivant.

### Règle n°2 : tout ou rien

Imaginez : le câble se débranche au milieu du transfert, après 300 mesures sur 638. Si le programme écrivait au fur et à mesure, on se retrouverait avec un fichier à moitié rempli, qui ressemble à un fichier normal. Et une application qui l'importe penserait que le lecteur ne contient que 300 mesures.

accuchek garde donc tout en mémoire et n'écrit le JSON sur la sortie standard **que si toute la session a réussi**. En cas d'échec, la sortie standard reste vide et la sortie d'erreur contient une seule ligne :

```bash
accuchek: failed to receive message data segment: Operation timed out (300 samples received before the error, none written)
```

Et le code de sortie dit de quelle famille de problème il s'agit :

<table id="bkmrk-code-signification-0"><thead><tr><th>Code</th><th>Signification</th></tr></thead><tbody><tr><td>0</td><td>succès, y compris un lecteur vide (<code>&#34;readings&#34;&#58; &#91;&#93;</code>)</td></tr><tr><td>1</td><td>mauvaise utilisation : option inconnue, fichier de config ou trace illisible</td></tr><tr><td>2</td><td>aucun lecteur connu sur le bus USB</td></tr><tr><td>3</td><td>lecteur trouvé mais accès refusé : règle udev absente ou pas chargée</td></tr><tr><td>4</td><td>transfert USB échoué : délai dépassé, lecteur débranché</td></tr><tr><td>5</td><td>protocole : le lecteur a abandonné ou a répondu quelque chose d'inattendu</td></tr></tbody></table>

Ces codes font partie du "contrat" du programme : Glucofi s'en sert directement pour choisir le message à afficher.

### Pouvoir travailler sans lecteur

Le gros problème du reverse engineering d'un appareil, c'est qu'on ne peut tester qu'avec l'appareil sous la main. Et je n'allais pas emprunter le lecteur de mon proche à chaque modification du code, ni lui demander de se piquer le doigt pour avoir des mesures de test !

C'est là que le découpage en trois opérations du chapitre 2 (`controlStatus`, `bulkOut`, `bulkIn`) prend tout son sens. Elles forment une interface abstraite, `Transport`, et la session ne parle qu'à cette interface. Il en existe trois versions :

- `LibusbTransport` : le vrai lecteur, via libusb ;
- `RecordingTransport` : il se place devant le vrai lecteur et **enregistre** chaque transfert dans un fichier texte (option `--capture`) ;
- `ReplayTransport` : il **rejoue** un fichier enregistré comme si le lecteur était branché (option `--replay`).

Le format d'une trace est volontairement tout simple, lisible à l'œil nu :

```bash
# accuchek trace v1
c 0000
< E2000032800000000001002A...
> E300002C0003507900268000...
< !-7
```

Une ligne par transfert, avec son sens et ses octets en hexadécimal. Une erreur USB s'écrit avec un `!` suivi du code d'erreur libusb (ici `-7`, un délai dépassé). Au rejeu, le programme vérifie aussi que ce qu'il **envoie** correspond exactement à ce qui avait été envoyé. Si je change par erreur un octet d'un message sortant, le rejeu échoue en montrant les deux versions côte à côte.

La trace d'un téléchargement raté est gardée elle aussi : c'est justement là qu'elle est la plus utile pour comprendre ce qui s'est passé.

### Un lecteur simulé

Pour les tests, j'ai écrit un simulateur (`tests/sim.h`) qui fabrique les paquets qu'enverrait un lecteur, avec la même disposition que ceux du pilote Tidepool et que les réponses capturées sur un vrai Accu-Chek Guide. On peut lui demander n'importe quel scénario : un lecteur vide, plusieurs paquets de données, des marqueurs repas, un lecteur qui refuse la mise à l'heure, un lecteur qui ne se décrit pas, un abandon en plein milieu...

À côté du simulateur, deux fichiers contiennent de **vraies réponses** d'un Accu-Chek Guide 925 (`guide925_mds_answer.hex` et `guide925_segment_info.hex`), avec le numéro de série, l'identifiant système et les dates remplacés. Ce sont eux qui garantissent que le décodage marche sur le vrai matériel, pas seulement sur ce que j'imagine qu'il envoie.

#### Les tests

Tout ça est vérifié par une suite de tests qui se lance avec une seule commande :

```bash
$ make test
accuchek: 105 tests, 0 failed checks
```

On y trouve trois familles :

- **les décodeurs** (`test_protocol.cpp`) : dates BCD, valeurs HI et LO, heure d'été, format JSON, carte d'identité du lecteur ;
- **les sessions complètes** (`test_session.cpp`) : chaque scénario du simulateur rejoué de bout en bout, plus des tests du programme lui-même en ligne de commande (codes de sortie, rien sur la sortie standard en cas d'échec, logs qui ne polluent jamais la sortie JSON, règle udev cohérente avec la liste des lecteurs connus, fonctionnement sans root) ;
- **les limites** (`test_bounds.cpp`) : des paquets coupés à chaque longueur possible, des compteurs qui mentent, des tailles absurdes.

Quand elles sont installées, les tests sont compilés avec **AddressSanitizer** et **UndefinedBehaviorSanitizer**, deux outils du compilateur qui font planter le programme à la moindre lecture hors mémoire ou au moindre comportement indéfini, même s'il n'aurait rien fait de visible en temps normal.

Il y a aussi `make schema-check`, qui rejoue toutes les traces de test et valide chaque sortie JSON contre un schéma formel (`schema/output.schema.json`). Si un jour la forme de la sortie change par accident, ce test le voit.

### Le fuzzing, ou l'art de tout casser exprès

Les tests vérifient les cas auxquels j'ai pensé. Le **fuzzing** sert à trouver ceux auxquels je n'ai pas pensé. Le principe : on prend des paquets valides et on les abîme au hasard, des centaines de milliers de fois. Couper un paquet, inverser un bit, remplacer un champ de longueur par `0xFFFF`, ajouter des octets au hasard, ou carrément envoyer du bruit. Puis on regarde si le programme tient le coup.

Le fuzzer d'accuchek a une petite astuce que j'aime bien : chaque paquet abîmé est placé **juste avant une page mémoire protégée**. Avec `mmap`, on réserve de la mémoire, et avec `mprotect`, on interdit tout accès à la page qui suit le paquet :

```cpp
map = (uint8_t *)mmap(0, mapSize, PROT_READ | PROT_WRITE, MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
mprotect(map + dataPages * page, page, PROT_NONE);       // la page d'après est interdite
auto start = map + dataPages * page - bytes.size();      // le paquet finit pile au bord
memcpy(start, bytes.data(), bytes.size());
```

Résultat : lire ne serait-ce qu'**un seul octet** de trop fait planter le programme immédiatement, même sans AddressSanitizer. Pas de place pour un débordement discret.

```bash
$ make fuzz
fuzz seed=20261001: 200000 iterations, ..., invariant failures 0, crashes 0
```

Le fuzzer ne cherche pas que les plantages, il vérifie aussi des "invariants" : un paquet accepté ne doit jamais contenir plus d'entrées qu'il ne peut physiquement en tenir, et une date ou une horloge invalide ne doit jamais être acceptée comme valide. Le hasard est déterministe (un générateur xorshift avec une "graine"), donc en cas de plantage, le fuzzer affiche la commande exacte pour rejouer cette itération précise :

```bash
FUZZ_ARGS="--seed S --from N --count 1" make fuzz
```

### L'intégration continue

Enfin, tout ça tourne automatiquement sur GitHub Actions à chaque modification : compilation, tests avec les sanitizers, validation du schéma JSON, 20 000 itérations de fuzzing, et vérification que `make install` place bien le programme et la règle udev. Une fois par semaine, le fuzzing monte à 200 000 itérations avec une graine différente à chaque fois.

<p class="callout success">Au final, il n'y a plus beaucoup de place pour la surprise. Si le lecteur répond quelque chose d'inattendu, accuchek s'arrête proprement, dit pourquoi, et n'écrit rien. Si tout se passe bien, on a la totalité des mesures, ni plus, ni moins.</p>

# Installer et utiliser accuchek

Assez de théorie, place à la pratique. Voici comment installer accuchek sur sa machine et récupérer ses mesures. Tout se passe dans un terminal, et il n'y a besoin des droits administrateur que pour l'installation.

### Les prérequis

accuchek a besoin d'un compilateur C++ (C++17), de `make` et des en-têtes de **libusb**. Selon la distribution :

<table id="bkmrk-distribution-paquets"><thead><tr><th>Distribution</th><th>Paquets</th></tr></thead><tbody><tr><td>Debian, Ubuntu</td><td><code>g&#43;&#43; make libusb&#45;1&#46;0&#45;0&#45;dev</code></td></tr><tr><td>Fedora</td><td><code>gcc&#45;c&#43;&#43; make libusb1&#45;devel</code></td></tr><tr><td>Arch</td><td><code>gcc make libusb</code></td></tr><tr><td>Mageia</td><td><code>gcc&#45;c&#43;&#43; make lib64usb1&#46;0&#45;devel</code></td></tr></tbody></table>

Par exemple, sous Debian ou Ubuntu :

```bash
sudo apt update && sudo apt install g++ make libusb-1.0-0-dev
```

### Compiler et installer

On récupère le code, on compile, on installe :

```bash
git clone https://github.com/Ronnarrdd/accuchek.git
cd accuchek
make
sudo make install
```

`make install` copie deux fichiers :

- le programme dans `/usr/local/bin/accuchek` ;
- la règle udev dans `/etc/udev/rules.d/70-accuchek.rules`.

Puis on demande à udev de prendre la règle en compte :

```bash
sudo udevadm control --reload
sudo udevadm trigger --subsystem-match=usb
```

<p class="callout info">Pour les curieux et les empaqueteurs : `make install` respecte les variables `PREFIX`, `DESTDIR` et `UDEVDIR` (par exemple `UDEVDIR=/usr/lib/udev/rules.d`). Par défaut, le binaire est compilé de façon portable, et `make OPTFLAGS="-O3 -march=native"` l'optimise pour la machine qui compile.</p>

### Première lecture

On branche le lecteur en USB. Son écran affiche "transfert de données". On lance alors :

```bash
accuchek > mesures.json
```

Selon le nombre de mesures en mémoire, ça prend quelques secondes. Si la commande ne dit rien et que `echo $?` affiche `0`, c'est gagné : tout est dans `mesures.json`.

### Les commandes utiles

```bash
accuchek > mesures.json                           # le premier lecteur connu trouvé
accuchek 1 > mesures.json                         # le deuxième, si plusieurs sont branchés
accuchek --set-time > mesures.json                # remet aussi l'horloge du lecteur à l'heure si besoin
accuchek --capture session.trace > mesures.json   # enregistre aussi l'échange USB
accuchek --replay session.trace > mesures.json    # rejoue un enregistrement, sans lecteur
accuchek --known-devices                          # liste des lecteurs acceptés
accuchek --config mes-lecteurs.txt                # ajouter ou désactiver des modèles
accuchek --help
```

### Ce qu'on obtient

Un seul objet JSON, toujours avec la même forme :

```json
{
  "format": 2,
  "meter": {"manufacturer": "Roche", "model": "925", "serial": "...", "firmware": "v1.9.6", "hardware": "G", "software": "", "system_id": "..."},
  "clock": {"meter": "2026/10/01 21:06:58", "pc": "2026/10/01 20:42:52", "offset_s": 1446, "settable": true, "pc_synchronized": true, "action": "set"},
  "glucose": {"announced": 638, "received": 638},
  "meal": {"announced": 576, "received": 576, "unmatched": 0},
  "readings": [
    {"id": 0, "epoch": 1617009120, "timestamp": "2021/03/29 11:12", "mg/dL": 133, "mmol/L": 7.388889, "status": 0, "meal": "before_meal"}
  ]
}
```

- `meter` : la carte d'identité du lecteur ;
- `clock` : son horloge, l'écart avec le PC, et ce qui a été fait (`set`, `within_tolerance`, `not_settable`, `pc_not_synchronized`...) ;
- `glucose` et `meal` : ce que le lecteur annonce et ce qu'on a reçu. Si les deux nombres diffèrent, il y a un souci ;
- `readings` : les mesures. `timestamp` est l'heure affichée par le lecteur, `epoch` la même heure convertie dans le fuseau horaire du PC, heure d'été comprise.

### Jouer avec les données grâce à jq

Le JSON se prête très bien à `jq`, l'outil en ligne de commande pour manipuler du JSON. Quelques exemples :

```bash
# la dernière mesure
jq '.readings[-1]' mesures.json

# uniquement les mesures à jeun
jq '.readings[] | select(.meal == "fasting") | {timestamp, "mg/dL"}' mesures.json

# les mesures hors échelle (HI ou LO)
jq '.readings[] | select(.range)' mesures.json

# un CSV date;valeur, à ouvrir dans un tableur
jq -r '.readings[] | select(.epoch) | [.timestamp, ."mg/dL"] | join(";")' mesures.json > mesures.csv
```

### Quand ça ne marche pas

<table id="bkmrk-code-de-sortie-que-f"><thead><tr><th>Code de sortie</th><th>Que faire</th></tr></thead><tbody><tr><td>2</td><td>Le lecteur n'est pas vu. Vérifier le câble (certains câbles micro-USB ne font que la charge), et regarder si <code>lsusb</code> affiche bien <code>173a&#58;21d5</code>.</td></tr><tr><td>3</td><td>Accès refusé : installer la règle udev (voir plus haut), puis débrancher et rebrancher le lecteur.</td></tr><tr><td>4 ou 5</td><td>Débrancher le lecteur, attendre que son écran s'éteigne, le rebrancher et attendre "transfert de données" avant de relancer.</td></tr></tbody></table>

Pour aller plus loin, le mode debug affiche des logs et l'hexdump de chaque paquet sur la sortie d'erreur, sans jamais toucher à la sortie JSON :

```bash
ACCUCHEK_DBG=1 accuchek > mesures.json 2> debug.log
```

<p class="callout warning">Un fichier `mesures.json`, une trace `.trace` ou un `debug.log` contiennent des données de santé. On les garde pour soi, on ne les colle pas dans un ticket ou un forum sans avoir retiré les mesures.</p>

# Et ensuite : Glucofi

Avoir un fichier JSON, c'est parfait pour moi. Pour mon proche, beaucoup moins. Lui, ce qu'il veut, c'est brancher son lecteur, cliquer sur un bouton, et voir où il en est. C'est pour ça que j'ai construit **Glucofi**, une petite application de bureau pour Linux (GTK4 / libadwaita, donc parfaitement à sa place sous Gnome), qui utilise accuchek en coulisses.

[![image.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/image.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/image.png)
### Comment accuchek a été importé

Plutôt que de copier-coller le code, je l'ai intégré avec un **git subtree** dans `services/device/accuchek-src`. Le code d'accuchek vit toujours dans son propre dépôt, et je peux récupérer ses mises à jour d'une seule commande :

```bash
git subtree pull --prefix=services/device/accuchek-src https://github.com/Ronnarrdd/accuchek.git main --squash
```

Il est compilé et installé dans `/usr/local/bin/accuchek` au moment de l'installation de Glucofi, avec sa règle udev.

### Glucofi ne parle jamais au lecteur directement

C'est un choix volontaire. Glucofi (en Python) ne touche pas à l'USB : il lance accuchek comme un programme séparé, avec les droits de l'utilisateur, et lit sa sortie. Tout ce qui décode des octets venus de l'extérieur reste dans le petit programme C++ testé et fuzzé, jamais en root.

Côté Python, tout est dans `services/device/accuchek.py` :

1. **Le lecteur est-il branché ?** Avant même de lancer quoi que ce soit, Glucofi regarde dans `/sys/bus/usb/devices/*/idVendor` s'il y a un périphérique Roche (`173a`). Pas besoin de droits particuliers pour ça.
2. **Lancer la lecture.** Il exécute `accuchek --set-time`, avec un délai maximum de 3 minutes. L'horloge du lecteur est donc corrigée au passage, si le PC est synchronisé et que l'écart dépasse 60 secondes.
3. **Interpréter le code de sortie.** Chaque code devient un message clair pour l'utilisateur. Le code 3, par exemple, donne "Accès USB au lecteur refusé : débranchez puis rebranchez le lecteur", ou indique la commande d'installation à relancer si la règle udev manque.
4. **Garder une copie brute.** Chaque lecture réussie est sauvegardée telle quelle dans `~/.local/share/glucofi/raw/`. Si un jour il y a un doute, on peut revenir à la source.
5. **Valider chaque mesure.** Le JSON est relu avec méfiance : types vérifiés, mesures avec un statut non nul ou une date invalide écartées (et listées), valeurs HI et LO reconnues grâce au champ `range`.
6. **Prévenir quand quelque chose cloche.** Si le lecteur annonce 638 mesures et qu'on en a reçu moins, si des marqueurs repas sont orphelins, ou si l'horloge du lecteur a plus de 5 minutes d'écart et n'a pas pu être corrigée, Glucofi l'affiche.

### Ce que fait Glucofi avec les mesures

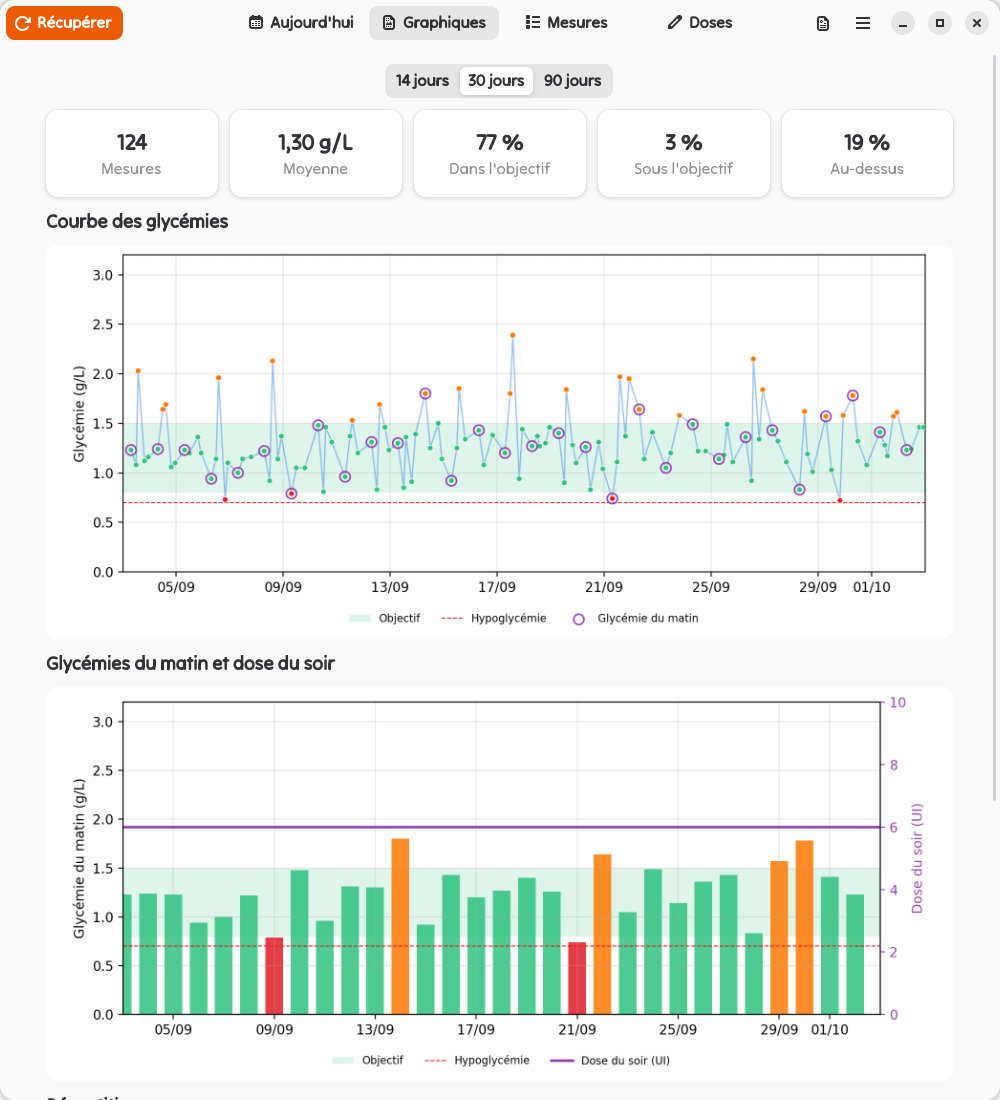
Une fois les mesures récupérées, Glucofi :

- les range dans une base **SQLite locale** (`~/.local/share/glucofi/glucofi.db`). Les doublons sont ignorés, on peut donc relire le lecteur autant de fois qu'on veut ;
- retrouve chaque jour la **glycémie du matin** : la première mesure entre 5h et midi marquée "à jeun", sinon "avant repas" ou sans marqueur. C'est là que les marqueurs repas du chapitre 5 servent vraiment ;
- applique le **protocole recopié depuis l'ordonnance** (seuils, pas d'ajustement, nombre de jours) pour **proposer** un ajustement de la dose du soir. Rien n'est appliqué sans un clic sur "Valider" ;
- affiche des **graphiques** sur 14, 30 ou 90 jours ;
- exporte un **PDF** à apporter au médecin.

[![image.png](https://librenard.fr/wiki/uploads/images/gallery/2026-10/scaled-1680-/idTimage.png)](https://librenard.fr/wiki/uploads/images/gallery/2026-10/idTimage.png)
Et surtout, tout reste sur la machine. Aucune donnée n'est envoyée nulle part, ça marche sans connexion Internet.

<p class="callout warning">Glucofi ne contient aucun protocole médical. Il applique uniquement les valeurs recopiées depuis une ordonnance écrite, et une proposition n'est jamais appliquée sans validation. Il ne remplace pas l'avis du médecin, et en cas d'hypoglycémie répétée ou de glycémie très élevée, appelez votre médecin (s'il vous plait).</p>

### Ce que j'en retiens

Ce projet m'a appris pas mal de choses, et pas seulement sur l'USB :

- **Le reverse engineering, c'est surtout de la lecture.** Lire le code des autres (Tidepool, emogenet), retrouver la norme derrière des noms de constantes, puis confronter tout ça aux vrais octets. L'hexdump de `ACCUCHEK_DBG=1` a été mon meilleur ami.
- **Un protocole "propriétaire" ne l'est pas toujours.** Derrière le lecteur Roche, il y a une norme publique, ISO/IEEE 11073. Une fois qu'on le sait, tout devient beaucoup plus lisible.
- **Pouvoir travailler sans le matériel change tout.** Les traces enregistrées et le simulateur m'ont permis de tester des centaines de scénarios sans emprunter le lecteur une seule fois de plus.
- **Quand il s'agit de santé, "ça marche" ne suffit pas.** Il faut que ça échoue proprement : pas de données à moitié lues, pas de mesures inventées, pas d'erreur

### Conclusion

Maintenant, quand mon proche veut faire le point, il branche son lecteur sur le PC, clique sur "Récupérer", et quelques secondes plus tard, ses glycémies du matin sont là, avec les graphiques et la proposition pour la dose du soir. Le carnet papier a pris sa retraite, et le jour de la consultation, il n'y a plus qu'à imprimer le PDF.

Le code est libre : accuchek est dans le domaine public (Unlicense), comme le projet d'origine d'emogenet, et Glucofi est sous licence GPL-3.0. Si vous avez un autre lecteur Roche, n'hésitez pas à essayer avec `--config` et à me faire un retour.

#### Liens utiles

- [Ronnarrdd/accuchek](https://github.com/Ronnarrdd/accuchek) : mon fork d'accuchek
- [emogenet/accuchek](https://github.com/emogenet/accuchek) : le projet d'origine
- [Pilote Roche du Tidepool uploader](https://github.com/tidepool-org/uploader/tree/master/lib/drivers/roche) : là où tout a commencé
- [Antidote](https://github.com/signove/antidote) : une implémentation libre de la norme ISO/IEEE 11073
- [libusb](https://libusb.info/) : la bibliothèque qui permet de parler à l'USB depuis un programme